
2023 年,当 ChatGPT 的热潮达到顶峰时,微软发表了一番出人意料的言论:数据中心缺电了。
这并不是说需要购买更多的 GPU。而是说,即便已经部署好的 GPU,其电力供应也已捉襟见肘。
全球数据中心消耗的电力中,有 30%~40% 并非用于计算。这些电力被消耗在数据从内存到处理器、再从处理器回到内存的移动过程中。价值数千亿韩元的 AI 基础设施,有近一半的时间是在等待中度过的。
问题不在于引擎,而在于道路拥堵。
如今你所使用的 AI 聊天机器人响应变慢,或者订阅价格波动,其中都掺杂了这种浪费。一旦服务器公司找到了节省电费的方法,部分节约成本最终会反映在资费上。数据中心电力问题不再是特定企业的财务报表项目,而是已经进入所有 AI 用户成本结构的变量。
因此,微软关于电力不足的言论并非简单的抱怨。无论增加多少 GPU,如果电网无法支撑,这些 GPU 就无法启动。不是半导体公司,而是电力公司在决定 AI 的扩展速度,这种情况已经发生。如果这种电力短缺中有相当大一部分不是因为运算,而是因为等待造成的,那么解决问题的顺序就必须改变。在建设更多发电厂之前,必须先堵住漏电的地方。
所谓“内存墙”的古老物理定律
1994 年,半导体行业为这一现象命名:内存墙(Memory Wall)。处理器的速度每年都在飞速增长,但内存与处理器之间的数据传输速度却无法跟上这种增长,这是一种物理极限。
三十年过去了。这堵墙并没有消失,反而变得更高了。
NVIDIA H100 GPU 每秒可处理数千万亿次运算。然而,当该 GPU 实际执行推理任务时——比如当用户请求预测下一句话时——运算装置等待数据而空转的时间往往超过了总时间的一半。
原因在于目前服务器主流内存 DDR5 的结构。DDR5 数据总线是单向单车道。读取和写入共享同一条物理线路。在传输数据时,其他数据无法进入,且每次改变方向时,都必须等待信号稳定。
这种等待时间被称为总线转向惩罚(Bus Turnaround Penalty)。每次转换大约需要 15~20 个时钟周期,折合时间为 11~15 纳秒。
纳秒听起来是一个很小的单位。但是,在 GPU 生成一个单词的过程中,会重复数亿次的内存读写。如果每次转换方向都要等待,数亿次累积下来,这就绝不是小损失了。
更严重的问题还在后面。即使在等待期间,内存总线上依然有电流流过。在不发送数据的情况下,它依然在为电路的寄生电容充电和放电,从而消耗电力。当 AI 思考时,电力就在毫无作为的情况下白白流失了。
这就是数据中心电力危机的实际结构。问题不在于 AI 运算本身,而在于 AI 等待的方式。
血管堵塞,心脏再强也无用
人体有一种直觉:心脏强壮的人身体健康。但如果动脉堵塞,情况就不同了。无论多强壮的心脏都无法将血液输送到身体的各个角落。这就是为什么心脏衰竭的原因往往不在于心脏本身。
计算机架构也具有相同的结构。处理器越强大,数据供应通道的问题就越突出。因为心脏变强了,但血管却没有相应地扩宽。
这个比喻之所以不仅仅是修辞,是因为两个系统的工作原理确实相似。血液循环的关键在于将氧气输送到组织与将二氧化碳带回肺部的流动同时进行。动脉和静脉使用完全独立的路径。因此,供应和回收可以同步进行。
如果动脉和静脉共用一条血管,血液在每次改变方向时都必须停止流动并等待。DDR5 就如同假设中的那种血管。
CXL(Compute Express Link)对应的是动脉和静脉分离的结构。它基于 PCIe(PCI Express)物理层,而 PCIe 本身就是为 송신(发送)线路和 수신(接收)线路在物理上分开的全双工(Full-Duplex)方式设计的。当读取数据在一条线路上流动时,写入数据可以同时在另一条线路上移动。方向转换惩罚从结构上彻底消失了。
实证数据以数字形式展示了这一差异。在读取和写入各占一半的混合流量环境中——实际的 AI 工作负载正是这种情况——CXL 系统的有效带宽比相同频率的 DDR5 通道高出 55~61%。
当然,这并非免费的午餐。由于需要进行 PCIe 数据包处理和经过外部控制器,信号延迟会增加。DDR5 的延迟为 75~85 纳秒,而 CXL 则在 130~200 纳秒左右。信号到达所需的时间几乎翻了一倍。
那么,CXL 难道不是更慢的技术吗?这里必须区分延迟(Latency)和带宽(Bandwidth)。延迟是第一个数据到达所需的时间,而带宽是单位时间内能传输的数据总量。这就像快火车发车频率低,与慢一点的火车不断接续行驶的区别。
GPT-4 或 LLaMA 等大型语言模型在进行推理时,需要的是不间断地供应数千亿个参数。数据供应的持续性比单次响应速度更能决定性能。在这种条件下,带宽带来的增益足以抵消延迟带来的损失。血管变粗了,心脏也就能跳动得更好了。
这与运动时身体的表现类似。当肌肉需要更多氧气时,心率会加快,血管同时会扩张。如果只提高心率而不扩张血管,只会导致压力增大,而真正到达组织的氧气量并没有显著增加。AI 推理也是如此。过去十几年我们只专注于提高处理器时钟频率,但真正的瓶颈其实在血管(总线)那一端。CXL 是扩宽血管的选择,之所以值得承担延迟这一微小成本,是因为实际的负载模式要求的是持续供应,而非瞬间反应。
这张图并非硬件的全部。要真正使用内存池化,还需要操作系统和虚拟机管理程序(Hypervisor)层面的软件栈共同成熟,以识别和配置异构内存。在多插槽环境中稳定保持缓存一致性,以及在出现故障时追踪哪个节点占用了多少内存,这些仍然是处于初期阶段的工程挑战。管道铺好了,水压并不会立即稳定。
被闲置的内存如何转化为价值
比起技术改进,有一个故事更直观:那就是钱。
大型数据中心运营商长期以来一直为一种现象头疼,即闲置内存,英文称为 Stranded Memory(被困内存)。意思是孤立的内存。
在当前的服务器结构中,内存物理固定在每个 CPU 节点上。当节点 A 的 CPU 完成工作停止后,插在该节点上的 256GB 内存就留在那里,无事可做。即使节点 B 需要更多内存,也无法借用节点 A 的内存。物理边界阻隔了这一切。
如果将这种情况扩展到数据中心规模,浪费的程度会大不相同。在数千台服务器中,实际负载高的节点只占少数。其余节点的大部分内存都在一边耗电一边闲置。理论上总容量是充足的,但特定节点却出现了内存不足。因此,他们购买了更多内存。而那些被闲置的内存依然留在那里。
CXL 交换机(Switch)解构了这种结构。在基于 CXL 的内存池化(Memory Pooling)架构中,物理内存通过虚拟化交换机被整合为一个共享资源池。如果节点 B 需要内存,它会立即从池中以 1GB 为单位进行分配;工作完成后,内存返回池中,供其他节点使用。
这对服务器容量规划意义重大。在传统模式下,为了应对峰值负载,必须过度配置内存。实际上,为了应对最坏情况,即使并不同时使用,也必须在每个节点上常驻足够的内存,而这些多余的部分正是闲置内存的来源。
有实证数据表明,在 CXL 池化环境下,构建相同可用内存的设备成本可降低最高 50%。 因为不需要在每个节点都装满超高密度的 RDIMM,而是通过将相对便宜的通用 64GB RDIMM 分散配置在 CXL PCIe 扩展插槽中,从而降低了采购单价。
运营成本的结构也随之改变。CXL 物理控制器中内置了以微秒为单位监测流量密度的电源管理电路。当数据流平缓时,它会将链路切换到超低功耗状态,当下一个请求到来时,在纳秒级完成恢复。根据三星电子的量产数据,这一机制将内存模块的闲置待机功耗降低了 50% 以上。
在此基础上还增加了行内(Inline)硬件压缩技术。如果将 ZeroPoint Technologies 的 DenseMem 压缩 IP 与 CXL 3.1 控制器封装在同一个 Die(裸片)中,数据压缩和解压将自动在硬件加速器端完成。在不占用任何 CPU 运算资源的情况下,将物理内存中存储的数据最高压缩至 3 比 1。
结果有些反直觉。即使不增加内存芯片的物理数量,操作系统识别的逻辑内存容量也会增加三倍。通过总线的信号包大小也减小了,传输功耗进一步降低。这是一个同时降低设备投资成本、运营成本和电力成本的结构。这就是 CXL 不仅仅停留于性能规格的原因。
如果将这些数字换算成能切身体会的单位:假设有一家运营万台规模 GPU 服务器的超大规模云厂商。内存设备投资减少一半,意味着可以用同样的预算增加更多的服务器,或者用一半的内存预算维持同样的服务器规模。无论哪种方式,原本被闲置内存锁定的资本都被释放出来了。而在此之前,这些资本只是站在那里耗电。
三星电子先行一步
在 CXL 从学术讨论落地为实际产品的过程中,有一家公司率先行动。
2021 年 5 月,三星电子开发了业界首款基于 CXL 1.1 的 CMM-D(CXL Memory Module-DRAM)。当时大多数服务器厂商将 CXL 列为 2025 年以后的技术。而三星在此之前就已经做出了实物。
2022 年 5 月,原生应用 CXL 2.0 规格的第二代 CMM-D 2.0 进入量产阶段。该产品在单插槽中支持最高 256GB,并稳定提供 36GB/s 的有效带宽。
下一步的 CMM-D 3.1 基于 PCIe 6.0 接口,在单模块中提供 1TB 内存空间,带宽达到每秒 72GB。这一数字不仅仅是规格的提升。这意味着单个 CXL 插槽开始超越传统直连 CPU 插槽的内存通道的总带宽限制。
SK 海力士选择了另一条路径。他们在 2026 年 3 月的全球闪存峰会上公开了下一代 CMM-DDR5 模块实物,同时开源了 HMSDK(异构内存软件开发工具包)。这是一份不只卖硬件的宣言。他们意在先建立一个让开发者可以通过软件直接控制异构内存池的生态系统。
美光(Micron)正在通过 2023 年开发的 CXL 2.0 兼容 CZ120 系列,通过一线数据中心的验证周期,积累商用可靠性数据。三家公司正从不同方向攀登同一座山峰。
NVIDIA 宣布将在 2026 年底发布的 Vera CPU 中默认搭载 CXL 3.1。英特尔的第五代至强(Xeon)和 AMD EPYC Turin 已经支持 CXL 2.0 以上标准,谷歌正在全球数据中心积极部署 CXL 物理互连。
市场等待规格的阶段已经过去。现在进入了规格引领市场的阶段。据行业估算,到 2028 年,全球 CXL 市场规模将增长至约 158 亿美元。2024 年的估算值仅为 12 亿美元。四年间翻了十三倍。
韩国为何能参与这场博弈
新规格正在重绘技术地图。原本有利的位置变得不再那么有利,而原本被封锁的入口正在打开。
韩国半导体产业长期以来一直存在不平衡结构。DRAM 制造能力世界顶尖,但在生产核心设计知识产权(IP)的无晶圆厂(Fabless)部门、负责高附加值封装的 OSAT 领域以及精密检测设备领域,本土企业很难挤进全球前列。这曾是一个擅长制造 DRAM 的国家,却不是主导半导体生态系统的国家。
CXL 正在撼动这一结构。新的互连标准需要新的芯片。交换机芯片、控制器芯片、PHY IP、检测设备、高层数基板。在这些领域,韩国企业展现出了异常领先的地位。
以 KAIST 研究团队为核心创立的 Panmnesia,开发出了全球首个完全执行基于端口路由(Port-based Routing)的 CXL 3.2 全规格单交换机芯片组。这款名为“PCIe 6.4-CXL 3.2 Fusion Switch”的芯片,在一个物理半导体内部将 CPU、GPU、加速器和共享内存设备绑定,连接为一个可组合的共享系统。它将经过交换机跳数(Switch Hop)时产生的延迟开销降低到了两位数纳秒以下,并将生成式 AI 推理的瓶颈之一——KV(键值)缓存处理,集成到了交换机内部的硬件加速电路中。它在 CES 2025 上获得了最高创新奖,并通过 A 轮融资筹集了 800 亿韩元,累计企业估值超过了 3,400 亿韩元。
由三星电子和 SK 海力士架构设计本部出身人员组成的 MetisX,则从另一个问题出发:与其将数据移动到 CPU 或 GPU 进行计算,不如直接在内存内部计算如何?他们将这一概念——“计算内存(Computational Memory)”在 CXL 3.0 架构上实现了。在 CXL 内存模块的控制器芯片组内内置向量运算引擎和数据压缩/过滤电路,AI 向量相似度计算或 RAG(检索增强生成)任务所需的大规模数据过滤在内存设备内部完成,仅将加工后的结果值传给处理器。总线上的往返数据量从根本上减少,处理器的发热也随之降低,冷却成本也相应缩减。他们在 A 轮融资中筹集了 600 亿韩元,并正在与全球云厂商进行共同工程研发。
Deutenosia 设计了专门处理生成式 AI 的 RAG 和长期记忆实现中核心的向量数据库任务——即将文本、图像和语音转换为高维数值向量并计算相似度——的 VDPU(向量数据处理单元)。他们正在将控制该单元的“Seahorse”平台商用化,并针对跨国 SoC 制造商和基板设计公司,将 VDPU 与 CXL 互连逻辑对齐进行 IP 授权销售。
即使不直接销售芯片,也有从生态系统中受益的方法。那就是出售设计资产(IP)。Openedges Technology 是一家专门从事 IP 的上市公司,向全球市场供应片上互连 IP、内存控制器 IP 和 PHY IP。对于想要量产基于 CXL 控制器芯片组的国内外晶圆厂客户来说,他们拥有必须授权的 DDR5/LPDDR5X IP。这是一种芯片每制造一片就会积累版税的结构,分析认为 2025~2026 年将是其临界点。
检测者掌控品质
与制造芯片同等重要的工作,是确认制造出来的芯片是否真正正常工作。
每当新规格出现,检测设备市场也会重新开启。现有的 DDR5 检测设备无法正确检测 CXL 模块。协议不同,速度不同,要求的测试条件也不同。
Neosem 是率先填补这一空白的公司。2023 年,他们率先将 CXL 1.1 标准检测平台商用化,随后完成了支持 CXL 2.0 规格的高速高温老化(Burn-in)检测设备的国产化,并向三星电子独家供应了商用 1 号设备。
Neosem 检测方式的不同之处在于动作条件的极端性。在内存实际运行过程中,通过连续施加极端温度升降的热应力来实时追踪缺陷。有些芯片在常温下工作正常,但在温度变化时才会显露错误,他们的工作就是在出厂前捕捉到这些错误。
全球半导体检测市场长期以来由美国的泰瑞达(Teradyne)和日本的爱德万测试(Advantest)垄断。这两家公司在每一代 DDR 更迭时,实际上都预先定义了检测标准。Neosem 成功在 CXL 这一新规格中,先于这两大巨头交付了量产检测设备。这相当于在标准更迭的短暂缝隙中,顺序发生了倒置。
Exicon 专注于开发应用三星电子晶圆厂 4 纳米工艺的 CXL 3.0 特化内存模块及协议分析设备,并基于 PCIe 接口分析专利在硅谷设立了分公司,致力于客户多元化。Fadu 正在对兼容 CXL 物理协议的控制器芯片组和基于 FPGA 的概念验证卡进行现场测试。Qualitas Semiconductor 确保了在无物理噪声情况下传输 64GT/s 以上速度的 PCIe 6.0/CXL 3.1 兼容 PHY 设计资产,并与全球系统半导体公司进行了早期验证。
没有基板,芯片就是空中楼阁
半导体芯片本身并不是成品。只有安装在基板(Substrate)之上,才能开始工作。CXL 高速信号对基板提出了特殊要求。为了让 64GT/s 以上的信号无失真地通过,基板材质和层叠设计必须与普通服务器基板不同。
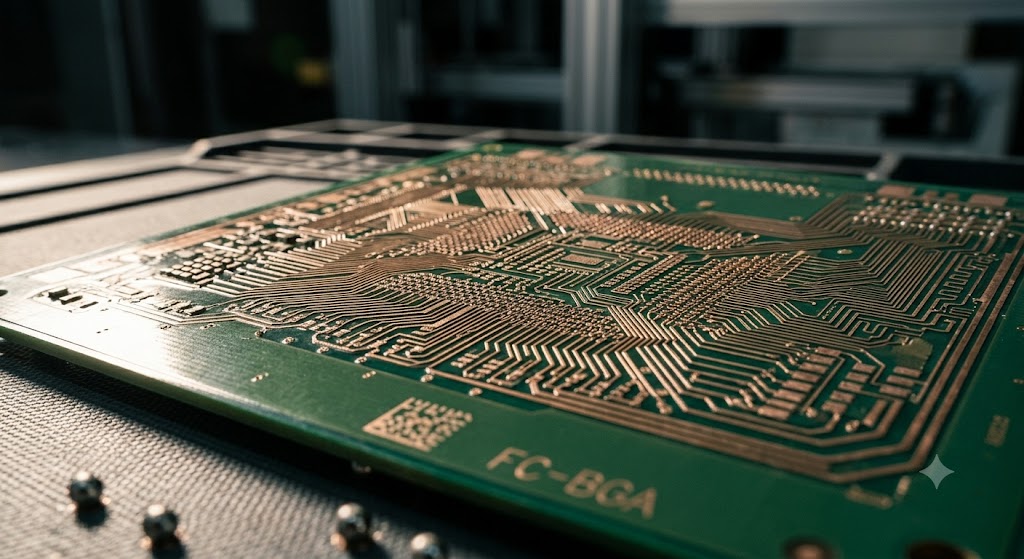
TLB 是一家率先掌握了 CXL 模块用高频动作无损信号传输层设计,以及下一代低功耗 LPCAMM 专用模块基板工艺技术的公司。为应对激增的全球需求,他们提前启动了越南第二工厂,并通过 AI 控制自动化机器人实现了个位数 ppm 的良率。他们同时也是三星电子和 SK 海力士的核心合作伙伴。
大德电子(Daeduck Electronics)是完成了 FC-BGA(倒装芯片球栅阵列)大型封装基板扩产投资的封装板制造商。随着凸点(Bump)接合密度变细且层数增加,产品单价呈跳跃式增长,因此在技术壁垒越高的地方,反而处于受益越大的位置。
列举至此,看起来像是一个完整的产业链。有交换机、控制器、检测设备和基板。但是,要让这些碎片真正咬合运转,还剩最后一步。
真正的战斗从这里开始
技术看起来已经齐备。有芯片、交换机、检测设备和基板。标准也已经定下。
那么,为什么 CXL 至今还不是服务器市场的主流?原因很多,但有一个意想不到的点卡住了:软件设计工具的成本。
Synopsys 或 Cadence 等跨国企业垄断的 EDA(电子设计自动化)软件是半导体设计的必备工具。授权费用每年高达数亿至数十亿韩元。即使 Panmnesia、MetisX、Deutenosia 等初创公司创造了世界首创的技术,如果想设计下一代芯片,依然必须使用这些软件。在产生有意义的量产营收之前,对于初创公司来说,这笔费用无异于扼住财务咽喉。
开发出世界首创技术的团队,却因为付不起租用下一代芯片设计工具的钱而停滞不前。
这不是技术问题,而是结构问题。
韩国科学技术信息通信部和中小风险企业部现在要做的事,不是把国家补助金拆细分发。而是应该大幅提高 EDA 软件采购费用的税额抵扣额度,并常态化运营长期租赁支持担保基金。还需要建立将三星电子、SK 海力士晶圆厂的 MPW(多项目晶圆)槽位优先分配给国内中小无晶圆厂的制度安排。
如果没有这些,开发出世界首创技术的团队在量产阶段被外国资本收购或被外国无晶圆厂吸收的情况就会反复上演。第一个制造出交换机芯片的国家,在芯片量产阶段却销声匿迹。
关于人类未来如何设计 AI 基础设施,新的规则正在书写。韩国企业第一次坐在了书写这些规则的谈判桌上。
如果只从公司层面看这场博弈,只能看到一半。一个数据中心的电力消耗现在已经增长到与一个中型城市相当的规模,在新建数据中心建设审批中,电网接入可行性往往成了先于选址的条件。电力公司和地方政府实际上已经站在了调节 AI 基础设施扩张速度的位置。
在这幅图中,CXL 的位置很微妙。这种通过减少内存瓶颈,从而以更少电力处理相同运算的技术,是比新建发电厂执行速度更快的少数几种解法之一。半导体设计问题与国家电力规划变量连接的点就在这里。当微软首次提到电力不足时,这句话就已经演变成了不仅仅是 GPU 公司的问题,而是电网运营商的问题。
内存墙的彼岸
三十年前,有一个问题被命名:内存墙。试图跨越这堵墙的尝试从未停止。制造更快的 DRAM,连接更多的通道,以更高的密度堆叠芯片。但这堵墙从未消失。
因为架构本身就在制造这堵墙。
CXL 是改变架构的尝试。它打破了内存与处理器之间的界限,制造了读取和写入可以同时流动的物理线路,将原本被固定在节点上闲置的内存变成了共享资源。
当这一变革完成时,带来的不会是更快的 AI。而是一个可以用更少电力使用更多 AI 的世界。
如果现在 AI 基础设施扩张的真正壁垒不是土地而是电网,且电力浪费的相当一部分源于数据等待的时间,那么 CXL 解决的问题就不是技术问题,而是能源问题。
如果能更高效地移动数据,就能以更低的成本将 AI 提供给更多的人。如今你使用的 AI 服务响应速度和订阅费用的部分,正是从这种内存总线的方向转换惩罚中流失的。
三十年来,业界一直奔向更强大的处理器。但墙壁总是出现在不同的地方。
下一堵墙会在哪里?而我们又要花多久才能察觉到那堵墙呢?
参考资料
- CXL Consortium 技术工作组。CXL 2.0 及 3.0 规范标准白皮书。Compute Express Link 官方技术文档存储库。2022–2024。
- KAIST 下一代内存系统联合研究所。用于下一代高带宽计算的内存层次结构及 CXL 互连性能分析。大韩民国学术院电子工程会报。2023。
- 三星电子内存事业部新事业战略组。CMM-D 产品系列技术路线图及数据中心内存瓶颈克服价值评估。Samsung Semiconductor 技术白皮书系列。2022–2024。
- ZeroPoint Technologies;Rambus 联合分析研究组。CXL 内存池化环境下的总拥有成本(TCO)及电力效率模型分析。IEEE Computer Architecture Letters。2024。
- 卢根昌等。韩国系统半导体企业异构计算范式抢占分析报告。现代汽车证券产业分析报告。2024–2025。
- SK 海力士解决方案开发中心软件研究所。HMSDK 及异构架构开源控制栈技术趋势。SK Hynix 技术研讨会发布资料。2026。
- Wulf, Wm. A.; McKee, Sally A. Hitting the Memory Wall: Implications of the Obvious. ACM SIGARCH Computer Architecture News. 1995.
- NVIDIA Corporation. Vera CPU Architecture Overview and CXL Integration Roadmap. NVIDIA GTC Technical Proceedings. 2025.
- Intel Corporation. 5th Gen Intel Xeon Processor Platform: CXL 2.0 Implementation Guide. Intel Developer Zone Technical Documentation. 2024.
- AMD Corporation. EPYC Turin Architecture: Memory Subsystem and CXL Controller Design. AMD Developer Resources. 2024.
- Google Infrastructure. Hyperscale Memory Disaggregation with CXL: Early Deployment Data from Production Workloads. Google Research Technical Report. 2025.
- Rambus Inc. PCIe 6.0 Physical Layer Controller for CXL 3.1: Performance and Power Characterization. Rambus Product Technical Documentation. 2024.
- Panmnesia。PCIe 6.4-CXL 3.2 Fusion Switch: Low-Latency Composable Memory Architecture. CES 2025 Innovation Award Technical Submission. 2025.
- MetisX。Computational Memory Architecture on CXL 3.0: Near-Memory Processing for AI Vector Workloads. Hot Chips Symposium Proceedings. 2025.
- Neosem。CXL 2.0 Module Burn-in Test Solution: Field Validation Report for Next-Generation Memory Qualification. 半导体设备技术协会发布资料。2024。