
MI300X의 메모리가 192GB인데도 개발자들은 왜 CUDA를 떠나지 못할까요?
엔비디아 CUDA 독점의 뿌리는 칩이 아니라 2006년 발표 이후 쌓인 CUDA 해자이고, 2026년 10월 19일 기준 AMD의 추격과 규제가 그 해자를 얼마나 흔들었는지 다시 확인했습니다.
2025년 8월에 쓴 글을 고치면서 로드맵, 벤치마크, 규제 현황, Run:ai 소식을 새로 확인했습니다.
그럼 CUDA 해자가 처음 파인 2006년으로 돌아가 보죠.
CUDA는 무엇이고 엔비디아 CUDA 독점은 어디서 시작됐나
GPU를 그래픽 말고 다른 계산에 쓰려던 초기 개발자들은 OpenGL이나 Direct3D 같은 그래픽 API를 억지로 돌려 써야 했습니다. 그래픽 용어로 계산 문제를 번역해야 했으니 전문 지식이 많이 들었고, GPU의 병렬 연산 능력을 제대로 끌어내기도 어려웠죠.
이에 엔비디아는 2006년 CUDA(Compute Unified Device Architecture)를 내놓았고, 첫 SDK는 2007년 2월 15일에 공개됐습니다.
C언어와 비슷한 방식으로 GPU의 수많은 병렬 처리 장치를 직접 다룰 수 있게 된 것입니다. GPGPU(범용 GPU 컴퓨팅)의 진입 장벽이 한꺼번에 내려간 사건이었고, 엔비디아가 개발자 중심 생태계를 짓기 시작한 첫 벽돌이기도 했습니다. 엔비디아가 게임용 그래픽 회사에서 AI 회사가 된 전체 흐름은 엔비디아 30년사: GPU·CUDA로 AI 시대 중심이 되기까지에 따로 정리해 두었습니다.
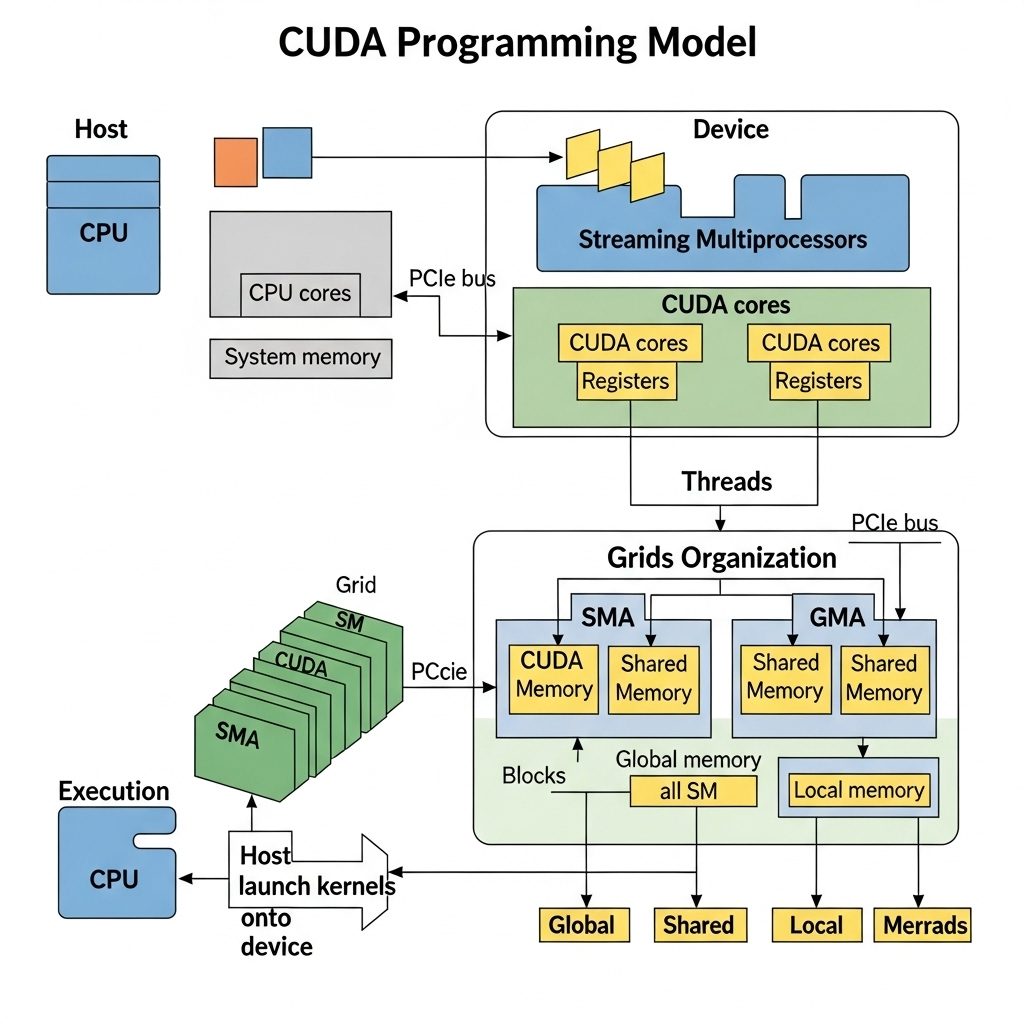
CUDA의 역할 분담은 단순합니다.
시스템의 주 프로세서 CPU가 호스트(Host), 병렬 연산을 맡는 GPU가 디바이스(Device)입니다.
GPU에서 병렬로 돌릴 함수는 __global__ 키워드로 정의하며, 이 함수가 커널입니다. 한 번의 계산은 대개 이 순서로 흘러갑니다.
- 호스트 메모리(RAM)의 데이터를 디바이스 메모리(VRAM)로 복사합니다.
- CPU가 GPU에 커널 실행을 명령합니다.
- GPU의 코어 수천 개가 같은 커널 코드를 동시에 실행합니다.
- 결과를 다시 호스트 메모리로 가져옵니다.
복잡한 그래픽 API의 속사정을 몰라도 이 네 단계만 이해하면 GPU의 연산 능력을 쓸 수 있다. 연구자와 개발자가 AI와 고성능 컴퓨팅(HPC)으로 몰려든 배경에는 이 낮은 문턱이 있었죠.
CUDA 해자는 왜 깊을까: 병렬 모델, 메모리 구조, 그리고 OpenCL과의 승부
CUDA가 소프트웨어 해자(Moat)로 불리는 이유, 한번 쓰면 빠져나오기 어려운 이유는 설계 안에 있습니다.
개발자에게 성능을 뽑아낼 정교한 도구를 쥐여 주면서, 그 도구가 엔비디아 하드웨어에 가장 잘 맞도록 짰기 때문입니다.
- 병렬 처리 모델: 스레드가 가장 작은 연산 단위이고, 스레드 여러 개가 블록을, 블록 여러 개가 그리드를 이룹니다. 작업을 수만 조각으로 쪼개 GPU 코어에 나눠 주는 방식인데, 이 사고방식에 익숙해진 개발자는 다른 아키텍처로 옮길 때 코드뿐 아니라 설계 습관까지 바꿔야 합니다.
- 메모리 계층: 블록 안에서 빠르게 데이터를 공유하는 공유 메모리는 개발자가 직접 관리하는 캐시처럼 쓰입니다. 알고리즘 최적화의 핵심 손잡이가 여기 있죠. 통합 메모리는 CPU와 GPU의 메모리 공간을 하나로 보이게 해 프로그래밍 부담을 덜어 줍니다.
- 컴파일러와 개발 도구: NVCC가 CUDA 코드에서 CPU용과 GPU용을 갈라 최적화하고, 디버거와 프로파일러가 그 위에서 돌아갑니다. Andreas Klöckner의 OpenCL 비교 글도 CUDA의 장점으로 성숙한 디버거, 프로파일러, CUBLAS·CUFFT 같은 라이브러리를 꼽았습니다.
그렇다면 여러 제조사에서 돌아가는 개방형 표준 OpenCL은 왜 밀렸을까요?
Modular의 CUDA 대안 분석을 보면 OpenCL은 공통 참조 구현 없이 명세로만 공개돼 제조사마다 구현이 갈라졌고, 위원회 중심 개발이라 진화가 느렸으며, AI용 라이브러리와 텐서 코어 표준 지원이 없었다는 것입니다. 이러한 사유로 AI 워크로드에서 CUDA 대비 5~10배 느리다고 추정해요. 이 대목에서 승부가 갈렸다고 봅니다. 이식성은 개발자가 얻는 이득이 먼 곳에 있는데, 새 하드웨어 기능을 빨리 쓰는 이득은 바로 눈앞에 있으니까요.
여기에 네트워크 효과가 붙습니다. 개발자가 늘수록 라이브러리가 늘고, 라이브러리가 늘수록 개발자가 더 모이죠. AI 연구자들이 CUDA 기반 코드와 논문을 내놓으면서 CUDA는 이 분야의 공용어(lingua franca)가 됐고, 후발 연구자는 기존 연구를 이어가려고 CUDA를 배울 수밖에 없었습니다. 개발자 경험에 길게 투자한 쪽이 시장 지배력을 얻는 플랫폼 경제학의 전형적인 사례입니다.
CUDA 위에 쌓은 풀스택: 라이브러리, DGX, 멜라녹스, Run:ai
엔비디아는 CUDA 위에 AI용 최적화 라이브러리를 겹겹이 올렸습니다.
cuDNN은 컨볼루션 같은 딥러닝 핵심 연산을 최적화한 라이브러리로, 엔비디아 개발자 블로그(2024년 6월)는 PyTorch, TensorFlow, XLA가 성능 엔진으로 이를 쓴다고 설명합니다. TensorRT는 학습이 끝난 모델을 서비스 환경에 맞게 줄이고 다듬는 추론 최적화 도구입니다. 두 라이브러리 덕에 개발자는 저수준 코딩 없이도 높은 성능을 얻는다. 그만큼 엔비디아 생태계에 더 깊이 묶이는 셈이다.
하드웨어도 낱개 칩으로는 잘 팔지 않아요.
DGX는 GPU에 NVLink, 고성능 스토리지, 최적화된 소프트웨어 스택을 묶어 한 번에 파는 서버 제품군이라, 고객은 인프라를 직접 조립하고 안정화하는 수고를 건너뛰는 대신 높은 가격과 강한 락인을 받아들입니다.
비슷한 논리가 소프트웨어와 서비스에도 이어집니다.
기업용 소프트웨어 묶음인 NVIDIA AI Enterprise는 GPU당 요금제(구독, 영구 라이선스, 클라우드 사용량 과금)로 팔리고, DGX Cloud는 주요 클라우드 사업자의 데이터센터에 DGX 인프라를 얹어 서비스로 내놓습니다. 옴니버스(디지털 트윈)와 Isaac(로보틱스)은 이 생태계를 물리 세계로 넓히는 시도입니다.
네트워킹도 같은 방향이에요.
엔비디아는 멜라녹스(Mellanox)를 69억 달러에 사들였고, 중국 시장감독총국(SAMR)은 이 인수를 2020년에 조건부로 승인했습니다. 멜라녹스는 고성능 컴퓨팅의 표준 네트워크 기술인 인피니밴드의 선두 기업이었고, 덕분에 엔비디아는 서버 안 GPU 간 통신뿐 아니라 서버 수백 대를 잇는 클러스터의 데이터 경로까지 설계할 수 있게 됐습니다. 여러 서버의 GPU가 CPU를 거치지 않고 네트워크로 직접 데이터를 주고받는 GPUDirect RDMA가 그 예입니다. GPU 칩만 파는 회사가 따라 하기 어려운 시스템 수준의 우위죠.
Run:ai 이야기는 2024년과 2026년이 많이 다릅니다.
Run:ai는 GPU 자원을 가상화해 효율적으로 나눠 쓰게 해 주는 소프트웨어 기업이고, 엔비디아는 2024년 4월 약 7억 달러(소식통 보도)에 인수를 추진해 EU 승인을 거쳐 2024년 12월 30일 완료했습니다. 인수 당시 Run:ai는 소프트웨어를 오픈소스로 공개해 AMD와 인텔 같은 경쟁사도 자기 하드웨어에 맞게 고쳐 쓸 수 있게 하겠다고 밝혔고, 엔비디아는 2026년 10월 13일 Run:ai 플랫폼 전체를 오픈소스로 공개했습니다. KAI Scheduler를 포함한 네 모듈이 있고, 저장소 코드는 Apache 2.0 라이선스를 따르며, 엔터프라이즈 지원은 유료로 남았습니다.
이 인수를 어떻게 읽을지는 해석의 영역이에요.
GPU 활용률을 높이는 소프트웨어는 GPU 판매량을 줄일 수 있는 기술이니, 그 계층을 직접 쥐면 고객이 GPU를 아껴 쓰려 할 때도 엔비디아 안에서 하게 만들 수 있다는 것입니다. 다만 오픈소스로 풀렸으니 이제는 문지기 역할보다 표준을 선점하는 쪽에 가깝습니다. 어느 쪽이 맞는지는 AMD나 인텔 GPU 위에서 이 스케줄러가 실제로 얼마나 쓰이는지로 갈릴 것으로 보입니다.
CUDA 해자에 도전하는 세 갈래: AMD ROCm, 인텔 oneAPI, 추상화 계층
도전자는 전략에 따라 세 부류로 나뉩니다.
CUDA를 따라가는 쪽(AMD), 개방형 표준으로 판을 바꾸려는 쪽(인텔), 하드웨어를 갈아 끼울 수 있게 만드는 소프트웨어 층(Triton, Mojo)입니다.
첫 번째 부류인 AMD는 오픈소스 플랫폼 ROCm으로 CUDA와 비슷한 대안을 내세웁니다. HIP API는 기존 CUDA 코드를 조금만 고치면 ROCm에서 돌게 설계돼 전환 장벽을 낮춥니다. 하드웨어 스펙만 보면 MI300X의 192GB HBM3와 5.3TB/s는 엔비디아 H200의 141GB HBM3e, 4.8TB/s를 앞섭니다. 메모리를 많이 쓰는 대형 언어 모델(LLM)에 유리한 구성이죠. 메모리 대역폭과 용량이 이야기의 전부가 아니라는 점은, 이 뒤의 실측이 보여 줍니다. HBM이 왜 이렇게 중요해졌는지는 HBM 전쟁: 엔비디아와 SK하이닉스 동맹의 미래에서 다뤘습니다.
SemiAnalysis가 2024년 12월 22일에 낸 학습 벤치마크는 소프트웨어 격차를 숫자로 보여 줬습니다. 이 글의 결론은 이랬다. AMD가 CUDA 해자를 메우려 애쓰는 동안 엔비디아 엔지니어들은 그 해자를 더 깊게 판다.
표 1. CUDA 해자 실측: MI300X와 엔비디아 H100/H200 비교 (SemiAnalysis, 2024년 12월 측정)
| 항목 | 엔비디아 H100/H200 | AMD MI300X |
|---|---|---|
| BF16 행렬 곱 (실측) | 약 720 TFLOP/s | 약 620 TFLOP/s (약 14% 낮음) |
| FP8 행렬 곱 (실측) | 약 1,280 TFLOP/s | 약 990 TFLOP/s (약 22% 낮음) |
| 2노드 학습 | H100이 10~25% 빠름 | 노드가 늘수록 격차 확대 예상 |
| 스케일아웃 네트워크 | 인피니밴드 | RoCEv2가 16~256MiB 메시지에서 약 절반 속도 |
| 공개 릴리스 기준 단일 노드 학습 | 일부 모델에서 2.5배 이상 우위 | 맞춤 빌드에서는 격차 축소 |
AMD가 이 격차를 그대로 두고 있지는 않습니다
. AMD가 2026년 4월 1일 발표한 MLPerf Inference 6.0 결과에서 후속 제품 MI355X는 Llama 2 70B 단일 노드 기준 엔비디아 B200과 오프라인에서 동률이었고, 서버 97%, 인터랙티브 119%였습니다. 같은 항목을 더 새로운 B300과 견주면 각각 92%, 93%, 104%예요. 11노드, GPU 87개를 묶은 멀티노드에서는 초당 100만 토큰을 넘겼고 스케일아웃 효율은 93~98%로 발표했습니다.
표 2. CUDA 독점에 맞선 MI355X 추론 성능: MLPerf Inference 6.0 단일 노드 (AMD 발표, 2026년 4월 1일 기준)
| 워크로드 | 엔비디아 B200 대비 | 엔비디아 B300 대비 |
|---|---|---|
| Llama 2 70B 오프라인 | 동률 | 92% |
| Llama 2 70B 서버 | 97% | 93% |
| Llama 2 70B 인터랙티브 | 119% | 104% |
| GPT-OSS-120B 오프라인 | 111% | 91% |
| GPT-OSS-120B 서버 | 115% | 82% |
이 표는 AMD가 자기 제출 결과를 정리한 숫자라는 점을 감안해야 합니다. 그래도 2024년 말 학습 벤치마크 시절의 “하드웨어는 좋은데 소프트웨어가 못 받쳐 준다"는 서술이 추론 단일 노드에서는 더는 그대로 쓰기 어렵게 됐습니다. 반대로 학습 성능과 대규모 확장성이 지금 어느 수준인지는 이번에 확인한 최신 1차 자료가 없습니다. 2024년 12월 측정치가 오늘의 ROCm을 대표한다고 단정할 수도, 낡았다고 단정할 수도 없는 상태입니다.
두 번째 부류인 인텔의 oneAPI는 SYCL 같은 개방형 표준 위에서 CPU, GPU, FPGA를 하나의 코드로 다루겠다는 시도입니다. 인텔은 자체 벤치마크(H100과 MI250)에서 CUDA 코드를 SYCL로 옮겨도 성능이 비슷하게 유지된다고 주장합니다.
하지만 AI 가속기 쪽 전략은 흔들습니다. 인텔은 2025년 1월 31일 Falcon Shores를 취소하고 후속인 Jaguar Shores로 방향을 틀었으며, 출시 시기는 밝히지 않았습니다. 하드웨어 로드맵이 불확실한 개방형 표준은 이식성이라는 약속만으로 개발자를 움직이기 어렵습니다.
세 번째 부류가 가장 근본적인 위협일 수 있어요. 하드웨어를 부품으로 만드는 소프트웨어 층에서 나올 수 있습니다. 파이썬으로 짠 코드가 어느 GPU에서든 높은 성능을 낸다면, 락인을 지탱하던 개발자 습관이 힘을 잃기 때문입니다.
OpenAI의 Triton은 파이썬과 비슷한 문법으로 GPU 커널을 짜는 오픈소스 언어입니다. 메모리 병합, 공유 메모리 관리, 스트리밍 멀티프로세서 안의 스케줄링을 컴파일러가 자동으로 처리합니다. 2021년 7월 1.0 공개 때는 엔비디아 GPU만 겨냥했지만, 지금은 GitHub 문서에 NVIDIA(컴퓨트 capability 8.0 이상)와 AMD(ROCm 6.2 이상)가 함께 지원 대상으로 올라 있습니다.
Modular의 Mojo는 파이썬의 편의와 C++·Rust급 성능을 목표로 MLIR 위에 처음부터 CUDA에 기대지 않고 설계한 언어입니다. 저수준 최적화에만 C++/CUDA를 써야 하는 “두 언어 문제"를 풀겠다는 구상이죠. 2025년 글에서는 이 언어를 “초기 단계"로 적었는데 2026년 8월 18일 ModCon에서 Mojo 1.0이 나오고 컴파일러와 도구 전체가 Apache 2.0 오픈소스가 됐습니다. Modular Cloud는 NVIDIA와 AMD GPU에서 운영 워크로드를 서비스하고, AWS Trainium, Google TPU, 퀄컴 가속기도 지원 대상에 추가했습니다. 2026년 7월 29일 발표된 퀄컴의 Modular 인수도 마무리됬습니다.
표 3. CUDA와 도전자 플랫폼 비교 (2026년 10월 19일 확인 기준)
| 속성 | CUDA | ROCm (HIP) | oneAPI (SYCL) | Triton | Mojo |
|---|---|---|---|---|---|
| 프로그래밍 모델 | C++ 확장, 독점 | C++ 기반, CUDA 유사 | C++ 기반, 개방형 | 파이썬 기반 | 파이썬 상위 집합 지향 |
| 하드웨어 지원 | NVIDIA 전용 | AMD 중심 | 벤더 중립 지향 | NVIDIA, AMD | NVIDIA, AMD 외 다수 가속기 |
| 오픈소스 여부 | 독점 | 오픈소스 | 개방형 표준 | 오픈소스 | 1.0, Apache 2.0 |
| 핵심 강점 | 성숙한 도구와 라이브러리 | CUDA 코드 이식(HIP) | 벤더 중립 | 높은 생산성 | 단일 언어, 이식성 |
| 핵심 약점 | 벤더 락인 | 학습·확장성 최신 근거 부족 | AI 가속기 로드맵 불확실 | 커널 작성 영역 한정 | 1.0 출시, 채택 사례 부족 |
이 표에서 Mojo 행이 가장 많이 달라졌다고 봅니다. 1년 전에는 “매우 낮음"이던 칸이 안정 버전과 오픈소스, 대기업 인수라는 숫자로 채워졌습니다. 다만 1.0이라는 이름이 곧 대규모 채택은 아닙니다. 확인한 것은 Modular의 자체 발표뿐이에요. GPU 바깥에서 AI 전용 칩으로 길을 내려는 경쟁도 있는데, 그쪽은 NPU란? AI 전용 반도체의 원리와 글로벌·한국 경쟁에서 따로 정리했습니다.
엔비디아 CUDA 독점을 겨눈 규제: 2026년 10월 기준 미국·프랑스·중국
아래 보도들에서 쟁점은 점유율 자체가 아니라 끼워팔기, 배타적 거래, 전략적 인수 같은 행위에 맞춰져 있습니다. 아래는 이번에 열어 본 자료로 확인되는 범위만 적었고, 공식 문서에서 직접 확인하지 못한 부분은 그렇게 표시했습니다.
미국은 2024년에 법무부(DOJ) 샌프란시스코 사무소가 소환장까지 보낸 조사로 알려졌습니다.
쟁점은 고객이 다른 칩 공급업체로 갈아타기 어렵게 만드는지, 엔비디아 제품만 쓰는 고객에게 공급과 가격에서 혜택을 주는지, 그리고 Run:ai 인수였습니다. 엔비디아는 품질과 성능으로 “실력으로 이긴다"고 반박했습니다. 2026년 9월 9일 뉴욕타임스 보도에 따르면 DOJ는 약 200억 달러 규모로 알려진 Groq 라이선스 거래가 반독점 심사를 피하도록 짜였는지 보려고 정보 요청서를 보냈고, 구체적 결론은 나오지 않았습니다.
프랑스 경쟁 당국은 2023년 9월 그래픽 카드 업계 현장 조사를 했고, 2024년 생성형 AI 보고서에서 CUDA 생태계 의존을 우려했습니다. 2026년 7월 기준 조사는 정식 이의제기서를 낼지 결정하는 막바지이며 사건을 불기소로 닫을 가능성도 열려 있고, 구체 혐의는 공식 공개되지 않았습니다. 이 글의 이전 판본에 있던 “가격 담합” 서술은 근거를 확인하지 못해 뺐다. EU 차원에서는 Run:ai 인수 심사 후 2024년 12월 승인이 확인되는 정도이고, CUDA 번들링을 다루는 EU 집행위 사건은 찾지 못했습니다.
중국 SAMR은 2024년 12월 멜라녹스 인수 승인 조건을 지켰는지 조사를 시작했고, 2025년 9월 15일 예비 조사에서 반독점법 위반이라고 발표했습니다. 어떤 조건을 어겼는지는 밝히지 않았고, 추가 조사 뒤에 처분이 정해집니다. 과징금은 전년 매출의 1~10% 범위다. 미중 무역 협상이 이어지던 시점에 나온 발표라 협상 카드라는 해석이 붙었습니다. 2026년 10월 기준 최종 처분은 확인하지 못했어요.
표 4. 엔비디아 CUDA 독점 관련 규제 현황 (2026년 10월 19일 기준, 확인한 범위)
| 관할권 | 확인된 사실 | 기준일 | 확인 못한 것 |
|---|---|---|---|
| 미국 (DOJ) | 2024년 소환장 보도, 2026년 Groq 거래 정보 요청 | 2024-09 / 2026-09-10 | 2024년 조사의 결론 |
| 프랑스 | 이의제기서 발부 여부 결정 임박 | 2026-07-12 | 구체 혐의, 결정 결과 |
| EU | Run:ai 인수 승인 | 2024-12 | CUDA 번들링 사건 |
| 중국 (SAMR) | 예비 조사에서 반독점법 위반 판단 | 2025-09-15 | 최종 처분과 과징금 |
Run:ai 인수를 “경쟁 억제용"으로 보는 시각은 DOJ 조사 쟁점에 인수가 포함됐다는 보도 정도만 근거가 있습니다. 게다가 2026년 10월에 이 소프트웨어 전체가 오픈소스로 풀렸으니, 억제 가설은 앞으로 더 설명하기 어려워졌습니다.
엔비디아는 CUDA 해자를 어떻게 지키나: 1년 주기 로드맵과 선택적 개방
엔비디아는 신제품 주기를 2년에서 1년으로 줄이겠다고 2025년 3월 GTC에서 밝혔습니다. 공개된 흐름은 Hopper(2022), Blackwell(2024), Blackwell Ultra(2025년 하반기 시스템), Vera Rubin(2026)으로 이어지고, 그 뒤로 Rubin Ultra는 Rubin 다음 해 하반기, Feynman은 그다음 세대로 알려졌습니다. 주기가 짧아지면 경쟁사는 목표가 계속 움직이는 상대를 쫓게 됩니다. 시장 전체가 엔비디아의 로드맵에 맞춰 움직이는 효과도 생기죠.
계획표가 현실이 됐는지가 2026년 가을의 관전 포인트예요. 2026년 6월 1일 Computex에서 엔비디아는 Vera Rubin이 전면 양산 중이고 출하는 올가을 시작이라고 밝혔습니다. 7월 15일에는 젠슨 황이 지연설을 부인했지만, 한 증권사 애널리스트는 SK하이닉스 HBM4 인증과 관련된 확인되지 않은 위험을 언급했습니다. 이 글을 쓴 시점에 고객 인도 일정은 공개되지 않았어요.
엔비디아가 팔려는 것은 칩이 아니라 하나의 그림이기도 합니다. 기업이 제품을 만들려고 공장을 짓듯 미래에는 지능을 생산할 데이터센터, 곧 AI 팩토리를 갖게 된다는 구상입니다. DGX와 AI Enterprise를 필수 설비로 보이게 만드는 이야기라서, 투자 규모를 정당화하는 마케팅 서사로도 읽힙니다.
개방도 전략의 일부입니. 엔비디아는 2024년 7월 17일 블로그에서 R560 드라이버부터 오픈 GPU 커널 모듈로 전환한다고 밝혔고, Grace Hopper와 Blackwell은 오픈 모듈이 필수입니다. Maxwell, Pascal, Volta는 독점 드라이버를 계속 씁니다. 여기에 2026년 10월의 Run:ai 전체 오픈소스 공개가 더해졌다. 반독점 압박 속에서 폐쇄 기업이라는 인상을 줄이는 계산이 깔렸다는 해석이 가능하지만, 어디까지나 해석입니다. 이번에 확인한 오픈소스 범위는 리눅스 커널 모듈과 Run:ai에 한정되고, CUDA 자체나 GPU 설계가 열렸다는 근거는 찾지 못했습니다.
CUDA 해자는 앞으로 버틸까: 세 가지 시나리오와 확인할 신호
지금까지의 근거로 시나리오를 나누면 이렇게 됩니다.
- 해자 유지: 2026년 4월 MLPerf에서도 단일 노드 일부 항목은 B300이 MI355X를 앞섰고, 엔비디아는 1년 주기로 계속 앞서 나갑니다. Vera Rubin 출하가 계획대로 가면 이 시나리오가 힘을 받는다.
- 해자 침식: MI355X가 B200과 비슷한 추론 성능을 내고, Triton이 AMD를 지원하며, Mojo 1.0이 오픈소스로 풀렸습니다. 소프트웨어 갭이 줄어드는 신호가 겹치는 중이다. 학습과 대규모 확장에서도 같은 일이 벌어지는지가 열쇠다.
- 해자 붕괴: 규제가 번들링을 직접 막는 경우다. 프랑스의 이의제기서, 중국 SAMR의 최종 처분, 미국 DOJ 조사의 결론 중 어느 것도 이번에 확인하지 못했으니 아직은 가능성의 영역이다.
중기적으로 엔비디아의 지배력이 상당 부분 유지될 가능성이 높고, 장기 변수는 규제보다 오픈소스 추상화 계층입니다. 다만 이 판단의 약한 고리는 학습 성능과 대규모 확장성의 최신 비교가 없다는 점입니다. 앞으로 석 달 동안 볼 신호는 세 가지예요. 2026년 가을 Vera Rubin의 실제 출하 시점, 프랑스 경쟁 당국이 이의제기서를 내는지 여부, SAMR의 최종 처분입니다.
참고자료
- CUDA
- NVIDIA H200 Tensor Core GPU
- AMD Instinct MI300X
- MI300X vs H100 vs H200 Benchmark Part 1: Training (SemiAnalysis, 2024-12-22)
- MLPerf 6.0: AMD Instinct MI355X GPUs Surpass 1M Tokens/Sec (AMD, 2026-04-01)
- CUDA vs OpenCL (Andreas Klöckner)
- Democratizing AI Compute, Part 5: What about CUDA C++ alternatives? (Modular)
- NVIDIA cuDNN 9로 트랜스포머 가속화 (NVIDIA Developer Blog, 2024-06-12)
- Nvidia completes acquisition of AI infrastructure startup Run:ai (TechCrunch, 2024-12-30)
- NVIDIA Run:ai Is Now Open Source as Part of NVIDIA DSX AI Factory Platform (NVIDIA Developer Forums, 2026-10-13)
- Nvidia Run Is Now Open Source: What's Free and Paid (TechRepublic)
- NVIDIA Released the Complete Run:ai Platform as Open Source (NeoTeo, 2026-10-16)
- China finds Nvidia violated antimonopoly law in preliminary probe (JURIST, 2025-09-16)
- Nvidia gets DOJ subpoena in escalating antitrust probe (Bloomberg 보도, 2024-09-04)
- Nvidia reportedly under DOJ investigation over Groq deal (PC Gamer, 2026-09-10)
- France nears decision on potential antitrust charges against Nvidia (PYMNTS, 2026-07-12)
- Intel axes Falcon Shores amid market challenges (TechTarget, 2025-01-31)
- oneAPI: A Viable Alternative To CUDA Lock-in (Intel)
- Introducing Triton: Open-source GPU programming for neural networks (OpenAI, 2021-07-28)
- triton-lang/triton (GitHub)
- ModCon 2026 announcements (Modular, 2026-08-18)
- 새로운 소식이 넘치는 'GTC 2025' 하이라이트 (NVIDIA Blog Korea, 2025-03-20)
- NVIDIA Computex 2026 news bytes: Vera Rubin now in production (ServeTheHome, 2026-06-01)
- Nvidia CEO says Vera Rubin is in production, denies delay (WinBuzzer, 2026-07-18)
- NVIDIA Transitions Fully Towards Open-Source GPU Kernel Modules (NVIDIA Developer Blog, 2024-07-17)
- "더이상 칩 회사 아냐"…아마존 닮아가는 엔비디아, 플랫폼 전략은? (이데일리, 2024-03-26)