
MI300Xのメモリが192GBもあるのに、なぜ開発者はCUDAから離れられないのでしょうか?
NVIDIA CUDAの独占の根源はチップそのものではなく、2006年の発表以来積み上げられてきた「CUDAの堀」にあります。2026年10月19日時点の状況をもとに、AMDの追撃と各国の規制がその堀をどれほど揺るがしているのかを再確認しました。
2025年8月に執筆した記事を修正し、ロードマップ、ベンチマーク、規制の現状、Run:aiの動向を新たに確認しました。
それでは、CUDAの堀が初めて掘られた2006年に遡ってみましょう。
CUDAとは何か、そしてNVIDIA CUDAの独占はどこから始まったのか
GPUをグラフィックス以外の計算に使おうとした初期の開発者たちは、OpenGLやDirect3DのようなグラフィックAPIを無理やり流用しなければなりませんでした。グラフィックス用語に計算問題を翻訳する必要があったため、専門知識が求められ、GPUの並列演算能力を十分に引き出すことも困難でした。
これに対し、NVIDIAは2006年にCUDA (Compute Unified Device Architecture) を発表し、最初のSDKが2007年2月15日に公開されました。
C言語に近い方法で、GPUの膨大な並列処理装置を直接扱えるようになったのです。これはGPGPU(汎用GPUコンピューティング)の参入障壁が一気に下がった出来事であり、NVIDIAが開発者中心のエコシステムを築き始める最初のレンガでもありました。NVIDIAがゲーム用グラフィックス企業からAI企業へと変貌を遂げた全体的な流れについては、NVIDIA 30年史:GPU・CUDAでAI時代の中心になるまでに別途まとめています。
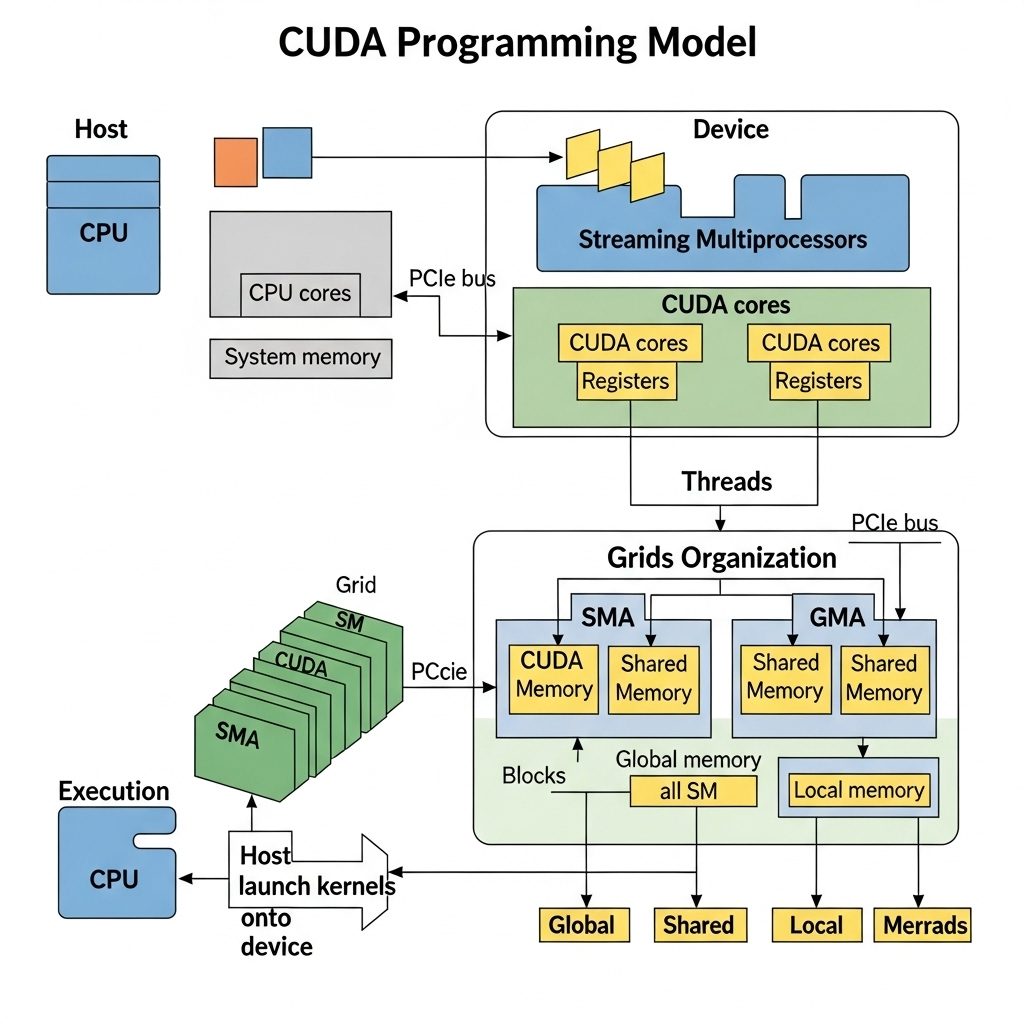
CUDAの役割分担は単純です。
システムの主プロセッサであるCPUがホスト(Host)、並列演算を担うGPUがデバイス(Device)です。
GPUで並列実行する関数は __global__ キーワードで定義し、この関数をカーネルと呼びます。一度の計算は、通常この順番で流れます。
- ホストメモリ(RAM)のデータをデバイスメモリ(VRAM)にコピーします。
- CPUがGPUにカーネル実行を命令します。
- GPUの数千個のコアが同じカーネルコードを同時に実行します。
- 結果を再びホストメモリに戻します。
複雑なグラフィックAPIの内部構造を知らなくても、この4ステップさえ理解すればGPUの演算能力を使える。研究者や開発者がAIやハイパフォーマンスコンピューティング(HPC)に殺到した背景には、この低い敷居があったのです。
CUDAの堀はなぜ深いのか:並列モデル、メモリ構造、そしてOpenCLとの勝負
CUDAがソフトウェアの「堀(Moat)」と呼ばれる理由、一度使うと抜け出しにくい理由は、その設計の中にあります。
開発者に性能を引き出すための洗練されたツールを与えつつ、そのツールがNVIDIAのハードウェアに最も最適化されるように作られているからです。
- 並列処理モデル: スレッドが最小の演算単位であり、複数のスレッドがブロックを、複数のブロックがグリッドを形成します。作業を数万の断片に分割してGPUコアに割り当てる方式ですが、この考え方に慣れた開発者は、他のアーキテクチャに移る際、コードだけでなく設計の習慣まで変えなければなりません。
- メモリ階層: ブロック内で高速にデータを共有する共有メモリは、開発者が直接管理するキャッシュのように使われます。アルゴリズム最適化の要となる部分です。統合メモリはCPUとGPUのメモリ空間を一つに見せることで、プログラミングの負担を軽減します。
- コンパイラと開発ツール: NVCCがCUDAコードからCPU用とGPU用を分離して最適化し、デバッガやプロファイラがその上で動作します。Andreas Klöckner氏のOpenCL比較記事でも、CUDAの利点として成熟したデバッガ、プロファイラ、CUBLAS・CUFFTのようなライブラリが挙げられています。
それでは、複数のメーカーで動作するオープン標準のOpenCLはなぜ敗北したのでしょうか?
ModularによるCUDA代替案の分析を見ると、OpenCLは共通の参照実装がなく仕様のみが公開されていたためメーカーごとに実装が分断され、委員会中心の開発ゆえに進化が遅く、AI用ライブラリやテンソルコアの標準サポートがなかったことが指摘されています。これらの理由から、AIワークロードにおいてはCUDAより5〜10倍遅いと推定されています。この点で勝負が決まったと言えます。移植性は開発者にとって将来的な利益ですが、新しいハードウェア機能を即座に使えるという利益は目の前にあったからです。
ここにネットワーク効果が加わります。開発者が増えるほどライブラリが増え、ライブラリが増えるほど開発者がさらに集まる。AI研究者がCUDAベースのコードと論文を出すことで、CUDAはこの分野の共通言語(lingua franca)となり、後発の研究者は既存の研究を継承するためにCUDAを学ばざるを得なくなりました。開発者エクスペリエンスに長期投資した側が市場支配力を得るという、プラットフォーム経済学の典型的な事例です。
CUDAの上に築かれたフルスタック:ライブラリ、DGX、Mellanox、Run:ai
NVIDIAはCUDAの上にAI用最適化ライブラリを幾重にも積み上げました。
cuDNNは畳み込み(Convolution)などのディープラーニングの核心演算を最適化したライブラリであり、NVIDIA開発者ブログ(2024年6月)では、PyTorch、TensorFlow、XLAがこれを性能エンジンとして使用していると説明しています。TensorRTは学習済みのモデルをサービス環境に合わせて軽量化・調整する推論最適化ツールです。これら二つのライブラリのおかげで、開発者は低レベルなコーディングなしで高い性能を得られます。その分、NVIDIAのエコシステムにより深く縛り付けられることになります。
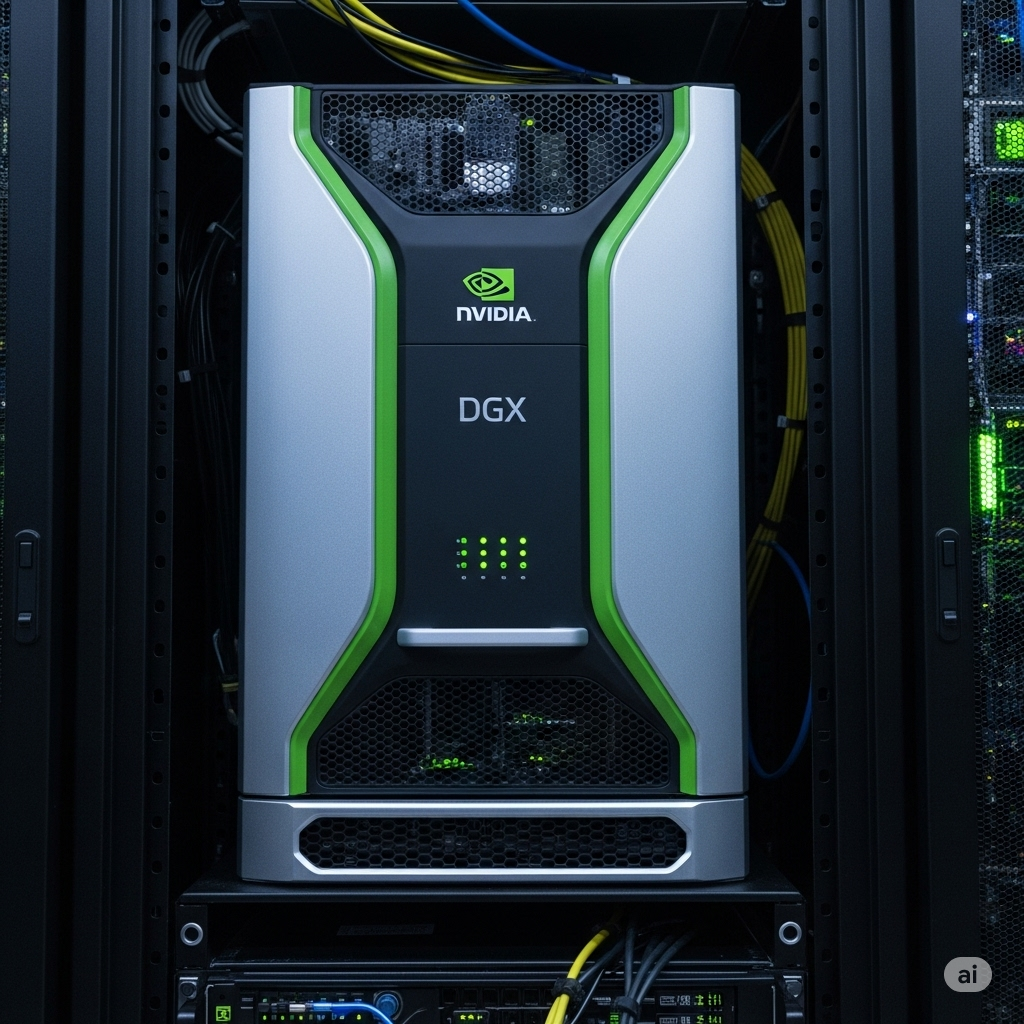
ハードウェアも単体チップとしてはあまり販売しません。
DGXはGPUにNVLink、高性能ストレージ、最適化されたソフトウェアスタックをパッケージ化して販売するサーバー製品群であり、顧客はインフラを自前で組み立てて安定化させる手間を省く代わりに、高い価格と強力なロックインを受け入れます。
同様の論理がソフトウェアとサービスにも適用されます。
企業向けソフトウェアパッケージであるNVIDIA AI EnterpriseはGPUごとの料金プラン(サブスクリプション、永続ライセンス、クラウド使用量課金)で販売され、DGX Cloudは主要クラウド事業者のデータセンターにDGXインフラを乗せてサービスとして提供されます。Omniverse(デジタルツイン)やIsaac(ロボティクス)は、このエコシステムを物理世界へと広げる試みです。
ネットワーキングも同じ方向性です。
NVIDIAはMellanoxを69億ドルで買収し、中国市場監督管理総局(SAMR)はこの買収を2020年に条件付きで承認しました。MellanoxはHPCの標準ネットワーク技術であるInfiniBandの先駆的企業であり、これによりNVIDIAはサーバー内のGPU間通信だけでなく、数百台のサーバーを繋ぐクラスターのデータ経路まで設計できるようになりました。複数のサーバーのGPUがCPUを介さずにネットワークを通じて直接データをやり取りするGPUDirect RDMAがその例です。GPUチップだけを販売する企業には真似できない、システムレベルの優位性です。
Run:aiに関する状況は、2024年と2026年で大きく異なります。
Run:aiはGPUリソースを仮想化して効率的に分割利用させるソフトウェア企業であり、NVIDIAは2024年4月に約7億ドル(消息筋報道)で買収を推進し、EUの承認を経て2024年12月30日に完了しました。買収当時、Run:aiはソフトウェアをオープンソースとして公開し、AMDやIntelなどの競合他社も自社ハードウェアに合わせて修正して使えるようにすると発表。NVIDIAは2026年10月13日、Run:aiプラットフォーム全体をオープンソースとして公開しました。KAI Schedulerを含む4つのモジュールがあり、リポジトリコードはApache 2.0ライセンスに従い、エンタープライズサポートは有料のまま残されています。
この買収をどう解釈するかは議論の余地があります。
GPUの稼働率を高めるソフトウェアはGPUの販売量を減らす可能性のある技術であるため、その層を直接掌握することで、顧客がGPUを節約しようとする場合でもNVIDIAのエコシステム内で完結させるという意図です。ただし、オープンソースとして公開された以上、現在は門番(ゲートキーパー)としての役割よりも標準を先取りする側面に近いです。どちらが正しいかは、このスケジューラがAMDやIntelのGPU上で実際にどれだけ使われるかによって判断されるでしょう。
CUDAの堀に挑む三つの道:AMD ROCm、Intel oneAPI、抽象化レイヤー
挑戦者はその戦略によって三つのグループに分かれます。
CUDAを追随する側(AMD)、オープン標準で盤面をひっくり返そうとする側(Intel)、ハードウェアを差し替え可能にするソフトウェア層(Triton、Mojo)です。
一つ目のグループであるAMDは、オープンソースプラットフォームROCmでCUDAの代替案を提示しています。HIP APIは既存のCUDAコードを少し修正するだけでROCmで動作するように設計されており、転換障壁を下げています。ハードウェアスペックだけを見ると、MI300Xの192GB HBM3と5.3TB/sは、NVIDIA H200の141GB HBM3e、4.8TB/sを上回ります。メモリを多用する大規模言語モデル(LLM)に有利な構成です。メモリ帯域幅と容量がすべてではないという点は、この後の実測値が示しています。HBMがなぜこれほど重要になったのかは、HBM戦争:NVIDIAとSKハイニックスの同盟の未来で扱いました。
SemiAnalysisが2024年12月22日に発表した学習ベンチマークは、ソフトウェアの格差を数字で示しました。この記事の結論は、「AMDがCUDAの堀を埋めようと努力する間、NVIDIAのエンジニアはさらに深く堀を掘り進めている」というものでした。
表1. CUDAの堀の実測:MI300XとNVIDIA H100/H200の比較(SemiAnalysis、2024年12月測定)
| 項目 | NVIDIA H100/H200 | AMD MI300X |
|---|---|---|
| BF16行列積(実測) | 約720 TFLOP/s | 約620 TFLOP/s(約14%低い) |
| FP8行列積(実測) | 約1,280 TFLOP/s | 約990 TFLOP/s(約22%低い) |
| 2ノード学習 | H100が10〜25%高速 | ノードが増えるほど格差拡大の予想 |
| スケールアウトネットワーク | InfiniBand | RoCEv2が16〜256MiBメッセージで約半分の速度 |
| 公開リリース基準の単ノード学習 | 一部モデルで2.5倍以上優位 | カスタムビルドでは格差縮小 |
AMDはこの格差を放置しているわけではありません。
AMDが2026年4月1日に発表したMLPerf Inference 6.0の結果において、後継製品のMI355XはLlama 2 70B単ノード基準でNVIDIA B200とオフラインで同等、サーバーで97%、インタラクティブで119%という結果でした。同じ項目をより新しいB300と比較すると、それぞれ92%、93%、104%となります。11ノード、GPU 87個を束ねたマルチノードでは秒間100万トークンを超え、スケールアウト効率は93〜98%と発表されました。
表2. CUDA独占に対抗するMI355Xの推論性能:MLPerf Inference 6.0単ノード(AMD発表、2026年4月1日時点)
| ワークロード | NVIDIA B200比 | NVIDIA B300比 |
|---|---|---|
| Llama 2 70B オフライン | 同等 | 92% |
| Llama 2 70B サーバー | 97% | 93% |
| Llama 2 70B インタラクティブ | 119% | 104% |
| GPT-OSS-120B オフライン | 111% | 91% |
| GPT-OSS-120B サーバー | 115% | 82% |
この表はAMDが自社で提出した結果をまとめた数字であるという点に留意が必要です。それでも、2024年末の学習ベンチマーク当時にあった「ハードウェアは良いがソフトウェアが追いついていない」という記述を、推論単ノードにおいてはそのまま適用することが難しくなりました。逆に、学習性能と大規模拡張性が現在どのレベルにあるのかについては、今回確認できた最新の一次資料はありません。2024年12月の測定値が今日のROCmを代表しているとも、古すぎて無意味だとも断定できない状態です。
二つ目のグループであるIntelのoneAPIは、SYCLのようなオープン標準の上でCPU、GPU、FPGAを一つのコードで扱おうという試みです。Intelは自社ベンチマーク(H100とMI250)において、CUDAコードをSYCLに移行しても性能はほぼ維持されると主張しています。
しかし、AIアクセラレータ側の戦略は揺れています。Intelは2025年1月31日にFalcon Shoresを中止し、後継のJaguar Shoresに舵を切りましたが、発売時期は明らかにしていません。ハードウェアロードマップが不透明なオープン標準では、移植性という約束だけでは開発者を動かすことは困難です。
三つ目のグループこそが最も根本的な脅威かもしれません。ハードウェアを部品化するソフトウェア層から生まれる可能性があるからです。Pythonで書かれたコードがどのGPUでも高い性能を出せるようになれば、ロックインを支えていた開発者の習慣が力を失うためです。
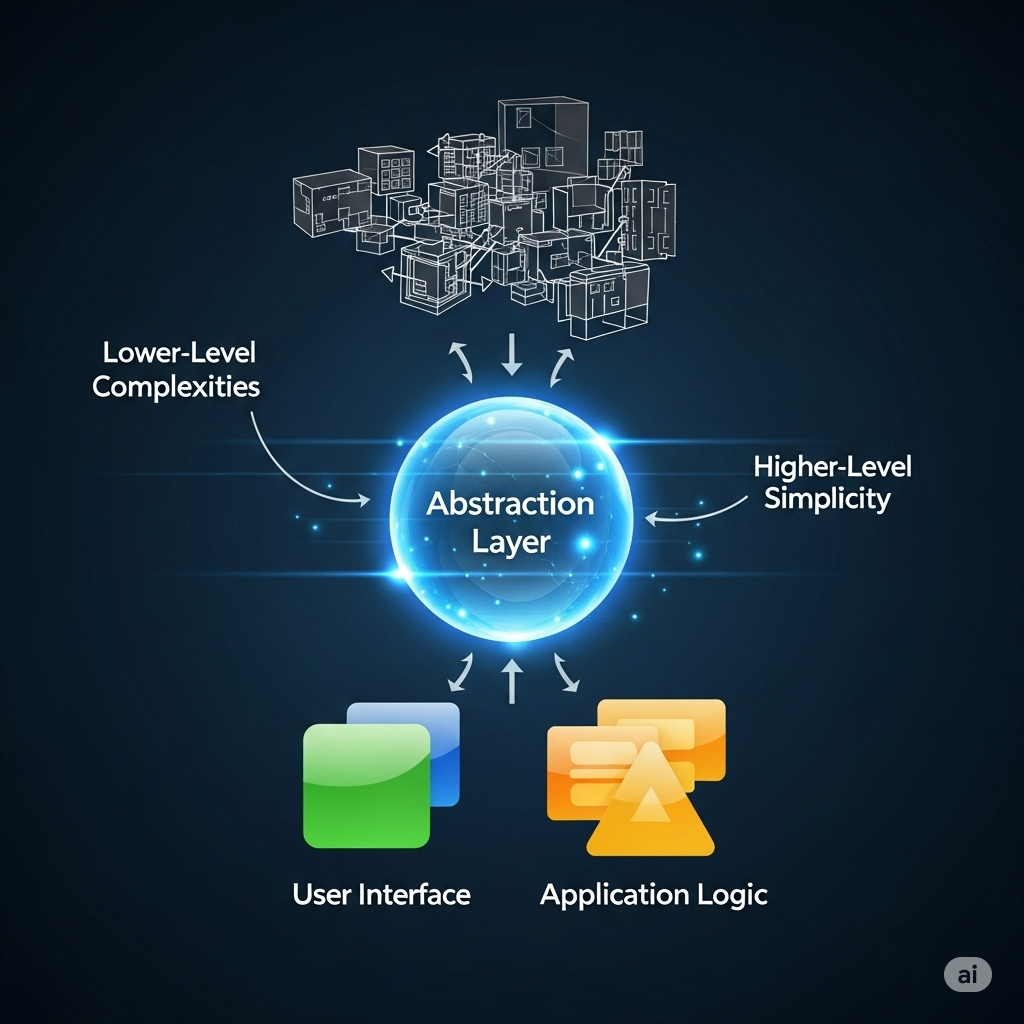
OpenAIのTritonは、Pythonに似た文法でGPUカーネルを書くオープンソース言語です。メモリ結合、共有メモリ管理、ストリーミングマルチプロセッサ内のスケジューリングをコンパイラが自動的に処理します。2021年7月の1.0公開時はNVIDIA GPUのみをターゲットにしていましたが、現在はGitHubのドキュメントにNVIDIA(Compute Capability 8.0以上)とAMD(ROCm 6.2以上)がサポート対象として記載されています。
ModularのMojoは、Pythonの利便性とC++・Rust級の性能を目標に、MLIRの上にCUDAに依存せず設計された言語です。低レベル最適化にのみC++/CUDAを使わなければならない「二つの言語問題」を解決するという構想です。2025年の記事ではこの言語を「初期段階」と書きましたが、2026年8月18日のModConでMojo 1.0が発表され、コンパイラとツール全体がApache 2.0オープンソースとなりました。Modular CloudはNVIDIAとAMD GPUで運用ワークロードをサービスし、AWS Trainium、Google TPU、Qualcommアクセラレータもサポート対象に追加しました。2026年7月29日に発表されたQualcommのModular買収も完了しています。
表3. CUDAと挑戦者プラットフォームの比較(2026年10月19日時点)
| 属性 | CUDA | ROCm (HIP) | oneAPI (SYCL) | Triton | Mojo |
|---|---|---|---|---|---|
| プログラミングモデル | C++拡張、独占 | C++ベース、CUDA類似 | C++ベース、オープン | Pythonベース | Python上位集合志向 |
| ハードウェアサポート | NVIDIA専用 | AMD中心 | ベンダー中立志向 | NVIDIA, AMD | NVIDIA, AMD他多数 |
| オープンソースか | 独占 | オープンソース | オープン標準 | オープンソース | 1.0, Apache 2.0 |
| 核心的な強み | 成熟したツールとライブラリ | CUDAコード移植(HIP) | ベンダー中立 | 高い生産性 | 単一言語、移植性 |
| 核心的な弱み | ベンダーロックイン | 学習・拡張性の最新根拠不足 | AIアクセラレータロードマップ不透明 | カーネル作成領域の限定 | 1.0リリース、採用事例不足 |
この表でMojoの行が最も変化したと考えます。1年前には「非常に低い」だった項目が、安定版とオープンソース化、大企業による買収という実績で埋まりました。ただし、1.0という名称が即座に大規模な採用を意味するわけではありません。確認できたのはModular自身の発表のみです。GPUの外部でAI専用チップとして道を切り開こうとする競争もあり、それについてはNPUとは?AI専用半導体の原理とグローバル・韓国の競争で別途まとめています。
NVIDIA CUDA独占を狙い撃つ規制:2026年10月時点の米国・フランス・中国
以下の報道における論点はシェアそのものではなく、抱き合わせ販売、排他的取引、戦略的買収といった行為に向けられています。以下は今回確認できた範囲でのみ記述しており、公式文書で直接確認できなかった部分はそう示しています。
米国では2024年に司法省(DOJ)サンフランシスコ事務所が召喚状まで送る調査を行っていることが報じられました。
論点は、顧客が他のチップサプライヤーに乗り換えにくくしているか、NVIDIA製品のみを使う顧客に供給や価格で優遇しているか、そしてRun:aiの買収でした。NVIDIAは品質と性能で「実力で勝っている」と反論しています。2026年9月9日のニューヨーク・タイムズの報道によると、DOJは約200億ドル規模とされるGroqライセンス契約が独占禁止審査を回避するように仕組まれているかを確認するため情報提供を求めており、具体的な結論は出ていません。
フランスの競争当局は2023年9月にグラフィックスカード業界の立ち入り調査を行い、2024年の生成AI報告書でCUDAエコシステムへの依存を懸念しました。2026年7月時点で調査は正式な異議申し立て書を送るかどうかの最終段階にあり、事件を不起訴で終了させる可能性も残されています。具体的な容疑は公式には公開されていません。以前の版にあった「価格カルテル」という記述は根拠を確認できず削除しました。EUレベルではRun:ai買収審査後に2024年12月の承認が確認される程度であり、CUDAバンドルを扱うEU執行委員会の事件は見当たりませんでした。
中国のSAMRは2024年12月にMellanox買収承認条件を遵守しているか調査を開始し、2025年9月15日の予備調査で独占禁止法違反と発表しました。どのような条件に違反したかは明らかにされておらず、追加調査の後に処分が決定されます。課徴金は前年売上の1〜10%の範囲です。米中貿易交渉が続いていた時期の発表であり、交渉カードという解釈もなされました。2026年10月時点で最終処分は確認できていません。
表4. NVIDIA CUDA独占に関連する規制状況(2026年10月19日時点、確認できた範囲)
| 管轄 | 確認された事実 | 基準日 | 確認できなかったこと |
|---|---|---|---|
| 米国 (DOJ) | 2024年召喚状報道, 2026年Groq取引情報要求 | 2024-09 / 2026-09-10 | 2024年調査の結論 |
| フランス | 異議申し立て書発行の決定間近 | 2026-07-12 | 具体的な容疑, 決定結果 |
| EU | Run:ai買収承認 | 2024-12 | CUDAバンドル事件 |
| 中国 (SAMR) | 予備調査で独占禁止法違反と判断 | 2025-09-15 | 最終処分と課徴金 |
Run:ai買収を「競争抑止用」と見る視点は、DOJの調査論点に買収が含まれたという報道程度のみが根拠です。さらに2026年10月にこのソフトウェア全体がオープンソース化されたため、抑止仮説は今後より説明が難しくなりました。
NVIDIAはCUDAの堀をどう守るのか:1年周期のロードマップと選択的開放
NVIDIAは新製品サイクルを2年から1年に短縮すると2025年3月のGTCで発表しました。公開された流れはHopper(2022)、Blackwell(2024)、Blackwell Ultra(2025年後半システム)、Vera Rubin(2026)へと続き、その後にRubin Ultra、Feynmanが次世代として知られています。サイクルが短くなれば、競合他社は目標が動き続ける相手を追うことになります。市場全体がNVIDIAのロードマップに合わせて動く効果も生まれます。
計画表が現実になったかどうかが2026年秋の観戦ポイントです。2026年6月1日のComputexで、NVIDIAはVera Rubinが全面量産中であり、出荷は今秋からだと発表しました。7月15日にはジェンスン・ファン氏が遅延説を否定しましたが、ある証券会社のアナリストはSKハイニックスのHBM4認証に関連する確認されていないリスクを言及しました。この記事を書いた時点で顧客への納入スケジュールは公開されていません。
NVIDIAが売ろうとしているのはチップではなく、一つの絵図でもあります。企業が製品を作るために工場を建てるように、未来には知能を生産するデータセンター、すなわち「AIファクトリー」を持つという構想です。DGXとAI Enterpriseを必須設備に見せる物語であり、投資規模を正当化するマーケティングの叙事詩としても読めます。
開放も戦略の一部です。NVIDIAは2024年7月17日のブログで、R560ドライバーからオープンGPUカーネルモジュールに転換すると発表し、Grace HopperとBlackwellはオープンモジュールが必須です。Maxwell、Pascal、Voltaは独占ドライバーを使い続けます。ここに2026年10月のRun:ai全体のオープンソース公開が加わりました。独占禁止圧力の中で閉鎖的な企業という印象を薄める計算があるという解釈が可能ですが、あくまで解釈です。今回確認したオープンソースの範囲はLinuxカーネルモジュールとRun:aiに限られ、CUDA自体やGPU設計が公開されたという根拠は見当たりませんでした。
CUDAの堀は今後も持ちこたえるか:三つのシナリオと確認すべき信号
これまでの根拠に基づきシナリオを分けると以下のようになります。
- 堀の維持: 2026年4月のMLPerfでも単ノードの一部項目はB300がMI355Xを上回り、NVIDIAは1年周期で先を行き続けます。Vera Rubinの出荷が計画通りに進めば、このシナリオが優勢になります。
- 堀の浸食: MI355XがB200と同等の推論性能を出し、TritonがAMDをサポートし、Mojo 1.0がオープンソース化されました。ソフトウェアギャップが縮まる信号が重なっています。学習と大規模拡張においても同じことが起きるかが鍵です。
- 堀の崩壊: 規制当局がバンドルを直接禁止する場合です。フランスの異議申し立て書、中国SAMRの最終処分、米国DOJ調査の結論のいずれも今回確認できなかったため、まだ可能性の範囲内です。
中期的にはNVIDIAの支配力がかなりの部分維持される可能性が高く、長期的な変数は規制よりもオープンソースの抽象化レイヤーです。ただし、この判断の弱い部分は、学習性能と大規模拡張性の最新比較がない点です。今後3ヶ月で見極めるべき信号は三つです。2026年秋のVera Rubinの実際の出荷時期、フランス競争当局が異議申し立て書を出すかどうか、SAMRの最終処分です。
参考文献
- CUDA
- NVIDIA H200 Tensor Core GPU
- AMD Instinct MI300X
- MI300X vs H100 vs H200 Benchmark Part 1: Training (SemiAnalysis, 2024-12-22)
- MLPerf 6.0: AMD Instinct MI355X GPUs Surpass 1M Tokens/Sec (AMD, 2026-04-01)
- CUDA vs OpenCL (Andreas Klöckner)
- Democratizing AI Compute, Part 5: What about CUDA C++ alternatives? (Modular)
- NVIDIA cuDNN 9によるTransformer加速 (NVIDIA Developer Blog, 2024-06-12)
- Nvidia completes acquisition of AI infrastructure startup Run:ai (TechCrunch, 2024-12-30)
- NVIDIA Run:ai Is Now Open Source as Part of NVIDIA DSX AI Factory Platform (NVIDIA Developer Forums, 2026-10-13)
- Nvidia Run Is Now Open Source: What's Free and Paid (TechRepublic)
- NVIDIA Released the Complete Run:ai Platform as Open Source (NeoTeo, 2026-10-16)
- China finds Nvidia violated antimonopoly law in preliminary probe (JURIST, 2025-09-16)
- Nvidia gets DOJ subpoena in escalating antitrust probe (Bloomberg報道, 2024-09-04)
- Nvidia reportedly under DOJ investigation over Groq deal (PC Gamer, 2026-09-10)
- France nears decision on potential antitrust charges against Nvidia (PYMNTS, 2026-07-12)
- Intel axes Falcon Shores amid market challenges (TechTarget, 2025-01-31)
- oneAPI: A Viable Alternative To CUDA Lock-in (Intel)
- Introducing Triton: Open-source GPU programming for neural networks (OpenAI, 2021-07-28)
- triton-lang/triton (GitHub)
- ModCon 2026 announcements (Modular, 2026-08-18)
- 新情報満載の「GTC 2025」ハイライト (NVIDIA Blog Korea, 2025-03-20)
- NVIDIA Computex 2026 news bytes: Vera Rubin now in production (ServeTheHome, 2026-06-01)
- Nvidia CEO says Vera Rubin is in production, denies delay (WinBuzzer, 2026-07-18)
- NVIDIA Transitions Fully Towards Open-Source GPU Kernel Modules (NVIDIA Developer Blog, 2024-07-17)
- 「もはやチップ企業ではない」…Amazonに似ていくNVIDIA、プラットフォーム戦略は? (Edaily, 2024-03-26)