
尽管 MI300X 拥有 192GB 内存,为什么开发者们依然无法离开 CUDA?
英伟达 CUDA 垄断的根源不在于芯片本身,而在于自 2006 年发布以来堆砌的“CUDA 护城河”。截至 2026 年 10 月 19 日,我们再次审视了 AMD 的追赶和监管政策对这条护城河的动摇程度。
在修订这篇 2025 年 8 月撰写的文章时,我重新核实了路线图、基准测试、监管现状以及 Run:ai 的最新动态。
那么,让我们回到 2006 年,回到 CUDA 护城河最初挖掘的时刻。
什么是 CUDA,英伟达 CUDA 垄断从何开始
早期的开发者如果想将 GPU 用于图形渲染以外的计算,不得不硬着头皮使用 OpenGL 或 Direct3D 等图形 API。由于必须将计算问题翻译成图形术语,这不仅需要大量专业知识,也难以充分发挥 GPU 的并行计算能力。
为此,英伟达在 2006 年推出了 CUDA (Compute Unified Device Architecture),首个 SDK 于 2007 年 2 月 15 日发布。
这意味着开发者可以通过类似 C 语言的方式直接操控 GPU 中众多的并行处理单元。这是 GPGPU(通用 GPU 计算)门槛大幅降低的标志性事件,也是英伟达构建开发者中心生态系统的第一块基石。英伟达从游戏显卡公司转型为 AI 公司的整体历程,已在 英伟达 30 年史:从 GPU/CUDA 到 AI 时代的中心 中单独整理。
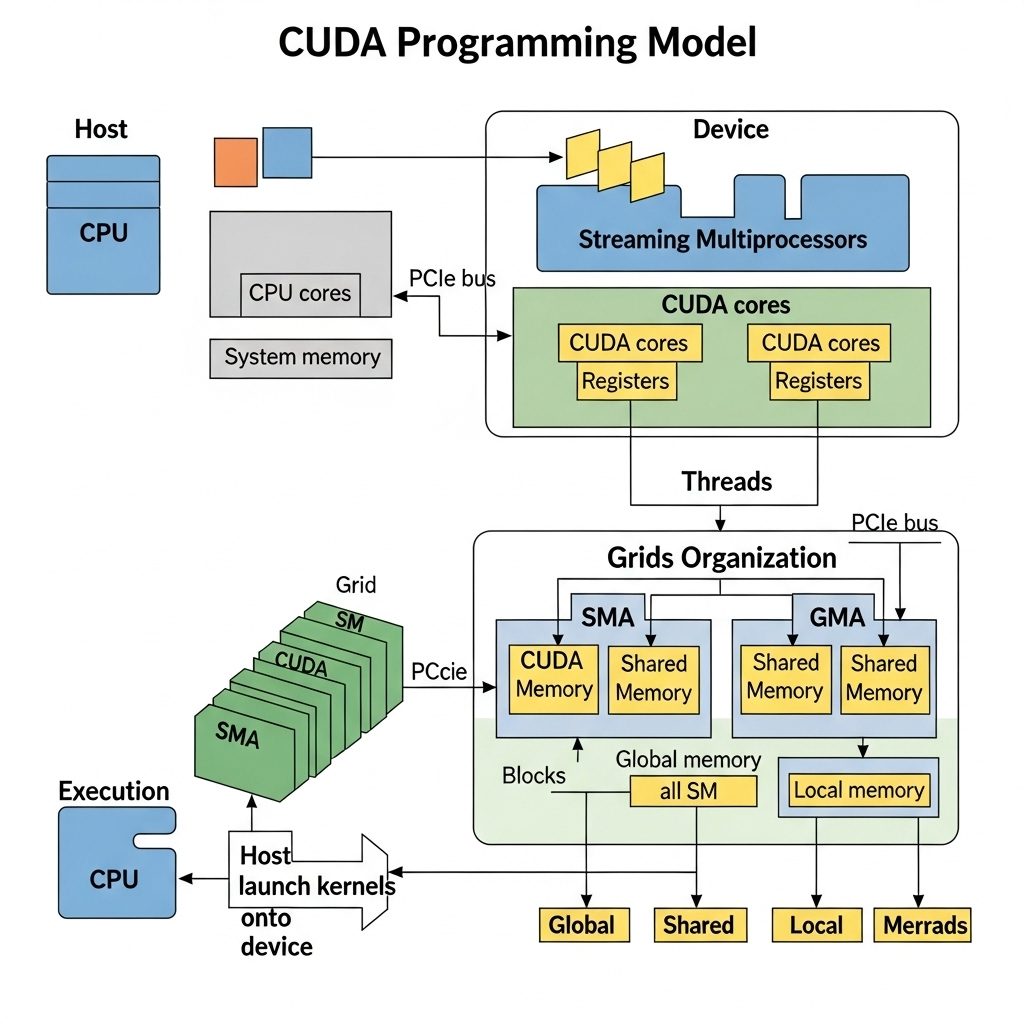
CUDA 的分工非常明确。
系统的主要处理器 CPU 是主机 (Host),负责并行计算的 GPU 是设备 (Device)。
在 GPU 上并行运行的函数需用 __global__ 关键字定义,该函数即为内核 (Kernel)。一次计算通常遵循以下流程:
- 将主机内存 (RAM) 中的数据复制到设备内存 (VRAM)。
- CPU 命令 GPU 执行内核。
- GPU 的数千个核心同时执行相同的内核代码。
- 将结果复制回主机内存。
无需深究复杂的图形 API,只需理解这四个步骤,就能使用 GPU 的计算能力。正是这一低门槛,吸引了大量研究人员和开发者涌向 AI 和高性能计算 (HPC) 领域。
CUDA 护城河为何深不可测:并行模型、内存结构与 OpenCL 之战
CUDA 被称为软件护城河(Moat),其原因在于其设计让开发者一旦使用就难以脱身。因为它在提供精细工具以榨取性能的同时,将这些工具针对 英伟达硬件 进行了深度优化。
- 并行处理模型: 线程是最小的计算单元,多个线程组成块 (Block),多个块组成网格 (Grid)。这种将任务拆解为数万个碎片分配给 GPU 核心的方式,一旦开发者习惯,迁移到其他架构时不仅要重写代码,还得改变设计思维。
- 内存层级: 块内快速共享的共享内存 (Shared Memory) 相当于开发者可手动管理的缓存,这是算法优化的核心手段。统一内存 (Unified Memory) 则使 CPU 和 GPU 的内存空间看起来像是一个整体,减轻了编程负担。
- 编译器与开发工具: NVCC 将 CUDA 代码分为 CPU 端和 GPU 端进行优化,调试器和分析器也在其上运行。Andreas Klöckner 的 OpenCL 对比文章 也将成熟的调试器、分析器以及 CUBLAS/CUFFT 等库列为 CUDA 的优势。
那么,支持多家厂商的开放标准 OpenCL 为何会落败?
Modular 的 CUDA 替代方案分析 指出,OpenCL 缺乏通用参考实现,仅以规范形式发布,导致各厂商实现各异;此外,其委员会驱动的开发模式演进缓慢,且缺乏对 AI 库和张量核心的标准化支持。据此推测,其在 AI 工作负载上比 CUDA 慢 5~10 倍。我认为这就是胜负的关键:移植性带来的益处往往在遥远的未来,而即时使用新硬件特性的收益却触手可及。
此外还有网络效应。开发者越多,库就越多,库越多,开发者就越聚集。随着 AI 研究人员发布基于 CUDA 的代码和论文,CUDA 成为了该领域的通用语 (lingua franca),后来的研究者为了延续前人的成果,不得不学习 CUDA。这是在开发者体验上长期投入从而获得市场支配力的 平台经济学 典型案例。
堆叠在 CUDA 之上的全栈:库、DGX、Mellanox、Run:ai
英伟达在 CUDA 之上层层堆叠了 AI 优化库。
cuDNN 是优化卷积等深度学习核心运算的库,英伟达开发者博客(2024 年 6 月)指出,PyTorch、TensorFlow 和 XLA 都将其作为性能引擎。TensorRT 则是用于将训练后的模型针对服务环境进行压缩和调整的推理优化工具。得益于这两个库,开发者无需编写底层代码即可获得高性能,同时也更深地绑定在英伟达生态中。
硬件方面,英伟达也不倾向于单独售卖芯片。
DGX 将 GPU 与 NVLink、高性能存储和优化的软件栈捆绑销售,客户虽然省去了自行组装和调试基础设施的麻烦,却也接受了高昂的价格和强绑定。
同样的逻辑也延伸到了软件和服务上。
企业级软件套件 NVIDIA AI Enterprise 以 按 GPU 计费(订阅、永久许可、云使用量计费)模式销售;DGX Cloud 则将 DGX 基础设施部署在主要云服务商的 数据中心 中以服务形式提供。Omniverse(数字孪生)和 Isaac(机器人)则是将该生态向物理世界扩展的尝试。
网络技术也是同一个方向。
英伟达以 69 亿美元收购了 Mellanox,中国国家市场监督管理总局 (SAMR) 于 2020 年有条件批准了该收购。Mellanox 是高性能计算标准网络技术 InfiniBand 的领军企业,得益于此,英伟达不仅能设计服务器内 GPU 间的通信,还能设计连接数百台服务器的集群数据路径。例如,多个服务器的 GPU 无需经过 CPU 即可通过网络直接交换数据的 GPUDirect RDMA。这是仅售卖 GPU 芯片的厂商难以企及的系统级优势。
Run:ai 的故事在 2024 年和 2026 年大不相同。
Run:ai 是一家通过虚拟化 GPU 资源实现高效共享的软件公司,英伟达在 2024 年 4 月推动收购(据报道约 7 亿美元),并于 2024 年 12 月 30 日在获得欧盟批准后完成。收购当时,Run:ai 表示将开源其软件,使 AMD 和英特尔等竞争对手也能修改并适配其硬件。2026 年 10 月 13 日,英伟达 将整个 Run:ai 平台开源。该平台包含 KAI Scheduler 等四个模块,仓库代码遵循 Apache 2.0 协议,企业级支持则保留收费。
如何解读这次收购见仁见智。
由于提高 GPU 利用率的软件可能会减少 GPU 的销量,直接掌握该层级意味着即使客户想要节省使用 GPU,也能将其限制在英伟达的体系内。但既然已经开源,它现在更倾向于抢占标准而非充当看门人。哪种判断正确,取决于该调度器在 AMD 或英特尔 GPU 上的实际使用率。
挑战 CUDA 护城河的三股力量:AMD ROCm、英特尔 oneAPI、抽象层
挑战者根据策略分为三类。
跟随 CUDA 的一方 (AMD),试图通过开放标准改变格局的一方 (英特尔),以及使硬件可更换的软件层 (Triton, Mojo)。
第一类 AMD 提出了开源平台 ROCm 作为 CUDA 的替代方案。HIP API 设计为只需稍作修改即可让现有的 CUDA 代码在 ROCm 上运行,降低了转换门槛。仅从硬件规格来看,MI300X 的 192GB HBM3 和 5.3TB/s 超过了英伟达 H200 的 141GB HBM3e 和 4.8TB/s。这是对内存需求大的大语言模型 (LLM) 有利的配置。但内存带宽和容量并非故事的全部,后续的实测数据说明了这一点。HBM 为何如此重要,我在 HBM 战争:英伟达与 SK 海力士同盟的未来 中进行了探讨。
SemiAnalysis 于 2024 年 12 月 22 日发布的训练基准测试 用数字展示了软件差距。结论是:在 AMD 努力填补 CUDA 护城河的同时,英伟达的工程师们正在把护城河挖得更深。
表 1. CUDA 护城河实测:MI300X 与英伟达 H100/H200 对比(SemiAnalysis,2024 年 12 月测量)
| 项目 | 英伟达 H100/H200 | AMD MI300X |
|---|---|---|
| BF16 矩阵乘法(实测) | 约 720 TFLOP/s | 约 620 TFLOP/s(低约 14%) |
| FP8 矩阵乘法(实测) | 约 1,280 TFLOP/s | 约 990 TFLOP/s(低约 22%) |
| 2 节点训练 | H100 快 10~25% | 随节点增加差距预计扩大 |
| 横向扩展网络 | InfiniBand | RoCEv2 在 16~256MiB 消息中速度约为一半 |
| 基于公开版本单节点训练 | 部分模型领先 2.5 倍以上 | 定制构建版差距缩小 |
AMD 并未坐视差距扩大。
AMD 于 2026 年 4 月 1 日发布的 MLPerf Inference 6.0 结果 显示,后续产品 MI355X 在 Llama 2 70B 单节点基准下与英伟达 B200 在离线模式下持平,服务器模式为 97%,交互模式为 119%。与更新的 B300 相比,分别为 92%、93% 和 104%。在 11 节点、87 个 GPU 的多节点测试中,每秒超过 100 万 token,横向扩展效率为 93~98%。
表 2. MI355X 推理性能对比(AMD 发布,截至 2026 年 4 月 1 日)
| 工作负载 | 对比英伟达 B200 | 对比英伟达 B300 |
|---|---|---|
| Llama 2 70B 离线 | 持平 | 92% |
| Llama 2 70B 服务器 | 97% | 93% |
| Llama 2 70B 交互 | 119% | 104% |
| GPT-OSS-120B 离线 | 111% | 91% |
| GPT-OSS-120B 服务器 | 115% | 82% |
需要注意的是,这些数字由 AMD 自行提交。尽管如此,2024 年底“硬件强但软件弱”的论调在推理单节点测试中已不再适用。相反,目前缺乏最新的 1 次资料来确认训练性能和大规模扩展性。不能断定 2024 年 12 月的测量结果代表了今天的 ROCm,也无法断定其已经过时。
第二类英特尔的 oneAPI 旨在在 SYCL 等开放标准之上,用一套代码操控 CPU、GPU 和 FPGA。英特尔声称在 自有基准测试(H100 与 MI250)中,将 CUDA 代码迁移至 SYCL 后性能保持一致。
但其 AI 加速器策略摇摆不定。英特尔于 2025 年 1 月 31 日 取消了 Falcon Shores,转而开发后继者 Jaguar Shores,且未披露发布时间。硬件路线图不明确的开放标准,很难仅凭“移植性”这一承诺打动开发者。
第三类可能是最根本的威胁:来自将硬件作为零件的软件层。如果用 Python 编写的代码能在任何 GPU 上发挥高性能,那么支撑绑定的开发者习惯将失去力量。
OpenAI 的 Triton 是一种使用类 Python 语法编写 GPU 内核的开源语言。编译器自动处理内存合并、共享内存管理和流式多处理器内的调度。2021 年 7 月发布 1.0 版本时仅针对英伟达 GPU,但现在 GitHub 文档 已将 NVIDIA(计算能力 8.0 以上)和 AMD(ROCm 6.2 以上)列为支持对象。
Modular 的 Mojo 旨在结合 Python 的便利性和 C++/Rust 级的性能,其在 MLIR 之上从头设计,不依赖 CUDA。它旨在解决必须使用 C++/CUDA 进行底层优化的“双语言问题”。在 2025 年的文章中,我将其描述为“早期阶段”,但在 2026 年 8 月 18 日的 ModCon 上,Mojo 1.0 发布,编译器和工具链全线开源为 Apache 2.0。Modular Cloud 在 NVIDIA 和 AMD GPU 上提供运营工作负载服务,并增加了对 AWS Trainium、Google TPU 和高通加速器的支持。2026 年 7 月 29 日宣布的高通收购 Modular 也已完成。
表 3. CUDA 与挑战者平台对比(截至 2026 年 10 月 19 日)
| 属性 | CUDA | ROCm (HIP) | oneAPI (SYCL) | Triton | Mojo |
|---|---|---|---|---|---|
| 编程模型 | C++ 扩展,专有 | 基于 C++,类 CUDA | 基于 C++,开放 | 基于 Python | 面向 Python 超集 |
| 硬件支持 | NVIDIA 专用 | 以 AMD 为中心 | 面向供应商中立 | NVIDIA, AMD | NVIDIA, AMD 及多款加速器 |
| 是否开源 | 专有 | 开源 | 开放标准 | 开源 | 1.0, Apache 2.0 |
| 核心优势 | 成熟工具与库 | CUDA 代码移植 (HIP) | 供应商中立 | 高生产力 | 单一语言,可移植 |
| 核心弱点 | 供应商绑定 | 缺乏最新训练/扩展证据 | AI 加速器路线图不明确 | 局限于内核编写 | 1.0 发布,缺乏采用案例 |
我认为表格中 Mojo 一行变化最大。一年前还是“极低”的栏目,现在填满了稳定版本、开源和被大企业收购的数据。不过,1.0 并不代表大规模采用,目前仅有 Modular 自己的声明。在 GPU 之外,还有向 AI 专用芯片发展的竞争,这部分我在 NPU 是什么?AI 专用半导体原理及全球/韩国竞争 中进行了梳理。
针对英伟达 CUDA 垄断的监管:2026 年 10 月的美、法、中
以下报道中的争议点并非市场占有率本身,而是捆绑销售、排他性交易、战略性收购等行为。下表仅记录了本次查阅资料所确认的范围,未在官方文件中直接确认的部分已作相应标注。
美国司法部 (DOJ) 旧金山办公室在 2024 年发出了 传票调查。
争议点在于是否增加了客户转向其他芯片供应商的难度,是否为仅使用英伟达产品的客户提供供应和价格优惠,以及 Run:ai 的收购。英伟达反驳称其是靠“实力取胜”。根据 2026 年 9 月 9 日《纽约时报》的报道,DOJ 已就据称规模约为 200 亿美元的 Groq 许可协议 是否旨在规避反垄断审查发出了信息请求,具体结论尚未公布。
法国竞争管理局于 2023 年 9 月对显卡行业进行了现场调查,并在 2024 年的 生成式 AI 报告中对 CUDA 生态依赖表示担忧。截至 2026 年 7 月,调查已进入决定是否提交正式异议书的最后阶段,也有可能以结案告终,具体嫌疑尚未公开。本文之前版本中关于“价格操纵”的描述因缺乏依据已删除。在欧盟层面,除了确认 2024 年 12 月批准 Run:ai 收购外,未发现针对 CUDA 捆绑销售的欧盟委员会案件。
中国 SAMR 于 2024 年 12 月开始调查其是否遵守了 Mellanox 收购时的附加条件,并于 2025 年 9 月 15 日宣布预调查结果为违反反垄断法。具体违反了哪些条件尚未披露,后续将经过进一步调查决定处罚。罚款金额在上一年度销售额的 1~10% 范围内。鉴于该公告发布于美中贸易谈判期间,舆论普遍将其视为谈判筹码。截至 2026 年 10 月,最终处罚结果尚未核实。
表 4. 英伟达 CUDA 垄断相关监管现状(截至 2026 年 10 月 19 日)
| 管辖区 | 已确认事实 | 基准日期 | 未确认事项 |
|---|---|---|---|
| 美国 (DOJ) | 2024 年传票报道,2026 年 Groq 交易信息请求 | 2024-09 / 2026-09-10 | 2024 年调查结论 |
| 法国 | 异议书发布决定临近 | 2026-07-12 | 具体嫌疑,决定结果 |
| 欧盟 | Run:ai 收购批准 | 2024-12 | CUDA 捆绑销售案件 |
| 中国 (SAMR) | 预调查认定违反反垄断法 | 2025-09-15 | 最终处罚与罚款金额 |
将 Run:ai 收购视为“遏制竞争”的观点仅有 DOJ 调查争议点包含该收购这一报道为依据。此外,2026 年 10 月该软件已全面开源,遏制假说在未来将更难自圆其说。
英伟达如何捍卫 CUDA 护城河:1 年周期路线图与选择性开放
英伟达在 2025 年 3 月的 GTC 上宣布 将新产品周期从 2 年缩短至 1 年。已公开的流程为 Hopper (2022)、Blackwell (2024)、Blackwell Ultra (2025 年下半年系统)、Vera Rubin (2026),之后是 Rubin Ultra 和 Feynman。周期缩短意味着竞争对手将持续追赶不断移动的目标。这也产生了整个市场随英伟达路线图而动的效果。
路线图是否成为现实是 2026 年秋季的看点。2026 年 6 月 1 日的 Computex 上,英伟达表示 Vera Rubin 已全面量产,将于秋季开始出货。7 月 15 日,黄仁勋 否认了延迟传闻,但某证券分析师提到了与 SK 海力士 HBM4 认证相关、未经证实的风险。截至本文撰写时,客户交付时间尚未公开。
英伟达试图售卖的不仅仅是芯片,而是一幅蓝图。正如企业为了生产产品而建设工厂,未来将拥有生产智能的数据中心,即“AI 工厂”。这使得 DGX 和 AI Enterprise 看起来像是必备设施,也是合理化投资规模的营销叙事。
开放也是策略的一部分。英伟达在 2024 年 7 月 17 日的博客 中宣布从 R560 驱动开始转向开源 GPU 内核模块,Grace Hopper 和 Blackwell 必须使用开源模块。Maxwell、Pascal、Volta 继续使用专有驱动。加上 2026 年 10 月 Run:ai 全面开源,这可以解释为在反垄断压力下减少其作为封闭企业的印象,但这仅仅是解读。目前确认的开源范围仅限于 Linux 内核模块和 Run:ai,未找到 CUDA 本身或 GPU 设计开放的证据。
CUDA 护城河未来会守住吗:三种情境与待确认信号
基于目前证据,情境可分为以下三种:
- 护城河维持: 在 2026 年 4 月的 MLPerf 中,B300 在部分单节点项目中领先于 MI355X,且英伟达保持 1 年周期持续领先。如果 Vera Rubin 按计划出货,该情境将得到支持。
- 护城河侵蚀: MI355X 达到与 B200 相当的推理性能,Triton 支持 AMD,Mojo 1.0 开源。软件差距缩小的信号正在叠加。关键在于训练和大规模扩展方面是否也会发生同样的事情。
- 护城河崩溃: 监管机构直接禁止捆绑销售。法国的异议书、中国 SAMR 的最终处罚、美国 DOJ 调查结论均未确认,因此这仍处于可能性领域。
中期来看,英伟达的支配地位很可能维持相当长一段时间,长期变量并非监管,而是开源抽象层。但该判断的薄弱环节在于缺乏训练性能和大规模扩展性的最新对比。未来三个月需关注的三个信号是:2026 年秋季 Vera Rubin 的实际出货时间、法国竞争管理局是否发出异议书、SAMR 的最终处罚。
参考资料
- CUDA
- NVIDIA H200 Tensor Core GPU
- AMD Instinct MI300X
- MI300X vs H100 vs H200 Benchmark Part 1: Training (SemiAnalysis, 2024-12-22)
- MLPerf 6.0: AMD Instinct MI355X GPUs Surpass 1M Tokens/Sec (AMD, 2026-04-01)
- CUDA vs OpenCL (Andreas Klöckner)
- Democratizing AI Compute, Part 5: What about CUDA C++ alternatives? (Modular)
- NVIDIA cuDNN 9 加速 Transformer (NVIDIA Developer Blog, 2024-06-12)
- Nvidia completes acquisition of AI infrastructure startup Run:ai (TechCrunch, 2024-12-30)
- NVIDIA Run:ai Is Now Open Source as Part of NVIDIA DSX AI Factory Platform (NVIDIA Developer Forums, 2026-10-13)
- Nvidia Run Is Now Open Source: What's Free and Paid (TechRepublic)
- NVIDIA Released the Complete Run:ai Platform as Open Source (NeoTeo, 2026-10-16)
- China finds Nvidia violated antimonopoly law in preliminary probe (JURIST, 2025-09-16)
- Nvidia gets DOJ subpoena in escalating antitrust probe (Bloomberg, 2024-09-04)
- Nvidia reportedly under DOJ investigation over Groq deal (PC Gamer, 2026-09-10)
- France nears decision on potential antitrust charges against Nvidia (PYMNTS, 2026-07-12)
- Intel axes Falcon Shores amid market challenges (TechTarget, 2025-01-31)
- oneAPI: A Viable Alternative To CUDA Lock-in (Intel)
- Introducing Triton: Open-source GPU programming for neural networks (OpenAI, 2021-07-28)
- triton-lang/triton (GitHub)
- ModCon 2026 announcements (Modular, 2026-08-18)
- 'GTC 2025' 高光时刻 (NVIDIA Blog Korea, 2025-03-20)
- NVIDIA Computex 2026 news bytes: Vera Rubin now in production (ServeTheHome, 2026-06-01)
- Nvidia CEO says Vera Rubin is in production, denies delay (WinBuzzer, 2026-07-18)
- NVIDIA Transitions Fully Towards Open-Source GPU Kernel Modules (NVIDIA Developer Blog, 2024-07-17)
- “不再是芯片公司”…越来越像亚马逊的英伟达,平台策略如何? (Edaily, 2024-03-26)