
英伟达进军CPU市场。
然而,没有人觉得这有什么异常。
2025年3月,黄仁勋在GTC大会上发布Vera CPU时这样说道:
“我们现在正在打造AI工厂。”
台下掌声雷动。但在这场发布会中,其实隐藏着一个更为重磅的真正宣言:
全球最大的半导体公司,正大步流星地迈入数十年来一直由英特尔和AMD垄断的数据中心CPU市场。次日英特尔股价下跌3.2%,AMD下跌1.8%。仅此而已。几天后,新闻头条便被其他琐事所取代。
然而,有一个低调的数据却不容忽视。
Vera CPU上市首年,预订金额就突破了200亿美元。
考虑到英特尔2024年整个数据中心业务部门的年营收仅为128亿美元,这绝非一次普通的新品发布。某些东西正在发生改变,而且是根本性的颠覆。
1. 我们未曾注意到的瓶颈
过去5年里,AI基础设施战争的叙事非常简单:
GPU至关重要。
更大的显存容量(VRAM)、更高的算力(FLOPS)、更快的互连速率。H100、A100、Blackwell。数以百亿美元计的投资全都在涌向这一个方向。
然而自2024年起,业界开始观察到一些反常现象。
当数据中心运维人员开始实测GPU集群的实际利用率时,浮现出了令人尴尬的数据:
在智能体工作流(Agentic Workflow)——即AI系统能够自主规划多步骤、调用工具并执行代码的场景中,GPU的实际运算利用率甚至还不到预期的一半。
GPU处于空闲状态,在等待。
在等待什么?-> 在等待CPU的处理与协助。
这不仅仅是一个简单的瓶颈,而是架构层面的裂痕。
-> 而英伟达在3年前就已经洞察到了这道裂痕。
让我们来看看智能体AI的运作方式。
当用户输入“帮我分析这份合同,检索相关判例,并撰写一份摘要报告”时,
AI并不仅仅是在生成文本。
它会制定计划 -> 选择工具 -» 调用API -> 解释结果 -> 决定下一步行动。
所有这些编排调度(Orchestration)工作并非在GPU上发生,而是在CPU上运行。
问题在于,这一编排调度的比重正在变得越来越大。
分析数据显示,在工具调用极其频繁的智能体工作流中,50%至最高88%的总延迟都发生在CPU处理工具调用的阶段。
剩下的12%至50%才是GPU上执行的实际推理计算。
价值数以万亿韩元的顶级GPU集群,有超过一半的时间都在空转,等待通用CPU完成处理。
这就是英伟达所看到的痛点。于是,英伟达决定亲自填补这个瓶颈。
2. 智能体AI重构的计算语法
聊天机器人(Chatbot)与AI智能体(Agent)之间的鸿沟,远比想象中要深广得多。
聊天机器人接收输入,通过单向变换输出结果。
其运算本质是大规模矩阵乘法,这恰恰是GPU所擅长的工作。
并行处理Token、与权重相乘并预测下一个Token。
在这一过程中,CPU的作用被最小化为仅负责下发指令与接收结果的协调管理者。
但智能体截然不同。
智能体在处理单次用户请求的过程中,所生成的Token数量至少是聊天机器人的15倍以上。
原因很简单。
智能体在做出每一个决策时都会进行内部独白(Internal Monologue):
“当前状况如下。接下来需要做的是那件事。我将以这种方式调用此工具。”
这种**“规划-执行-验证”的循环不断重复**,导致上下文爆炸式增长。
更重要的是,这15倍的计算量并不是均质的。
智能体所处理的大量计算具有顺序性、分支复杂且不可预测的特点。
调用哪个API、如何解析返回结果、出错时走哪条恢复路径——所有这些控制流都不是擅长并行处理的GPU的强项,而属于擅长复杂分支预测和顺序执行的CPU领域。
这就是计算格局的演变。
AI计算的重心正在从“单一的大规模并行矩阵计算”转向“复杂的顺序控制 + 大规模并行计算的反复交替组合”。
这对数据中心的设计产生了深远的影响。
以往的AI训练和推理数据中心,其架构通常是每吉瓦(GW)功耗配置约3000万个通用CPU核心。
而分析表明,为了承受智能体推理的编排调度负载,这一密度需要提升至每吉瓦1.2亿个核心的水准——即提升约4倍。
这不仅仅是需要更多CPU的问题。
而是CPU所承担任务的本质发生了改变:
从通用计算处理单元,转变为专为AI编排调度定制的高密度控制基础设施。
而此前,业内根本不存在针对该角色特别设计的CPU。
3. 奥林匹斯:拒绝通用的专属架构
还记得英伟达此前打造的Grace CPU吗?
2023年发布,基于Arm Neoverse V2核心。低调问世,低调应用。
Grace采用了直接授权Arm现成设计的稳妥路线,使用经过市场验证的核心。
而Vera截然不同。
Vera的核心是名为“奥林匹斯(Olympus)”的自研定制架构。
这是英伟达历史上首款自主设计的CPU核心,虽然兼容Armv9.2指令集,但其内部架构完全推倒重构。
为什么选择从零开始重新设计?
这个问题的答案足以阐明Vera的全部设计哲学。
通用CPU核心旨在处理各种各样的负载:文档处理、数据库、游戏以及编译器等。为了实现这种通用性,其分支预测器针对常见的常规代码模式进行了优化,缓存架构也是为了应对五花八门的内存访问模式而设计的。
但智能体AI所执行的代码,彻底脱离了这种“常规”模式。Python虚拟机、虚拟化沙箱工具、分布式数据库查询调度器——这些组件制造出了极其不规则且高度扭曲的控制流。
这会导致通用分支预测器的错误率急剧上升,流水线停顿(Pipeline Stall)频繁发生。
奥林匹斯核心的分支预测器和指令解码流水线正是针对这种特殊模式量身定制的。
其目标是以极低的延迟解析并处理不规则的顺序代码流。结果是:相比前代Grace核心,每时钟周期指令数(IPC)提升了1.5倍。
然而,奥林匹斯更具突破性的创新在于**“空间多线程(Spatial Multithreading)”**。
如果你了解英特尔的超线程技术(Hyper-Threading),就很容易理解这项技术的本质,以及传统超线程为何难以胜任。
超线程是在一个物理核心内,通过时间分片让两个逻辑线程共享资源——当一个线程等待内存时,另一个线程借机执行。
然而,当两个线程同时需要密集计算时(比如智能体同时调用两个工具并处理结果),
它们之间就会爆发对执行单元的争抢。这会导致抖动(Jitter)产生,响应时间变得极不稳定。
奥林匹斯核心的空间多线程采取了完全不同的思路。
它在硬件层面将88个物理核心内部的计算资源永久划分为两个完全独立的分区。
176个虚拟线程之间无法互相侵占资源,
从而确保每个线程都能稳定获得相当于独立物理线程级别的性能表现。
即使成千上万个独立的智能体同时调用编译器并运行沙箱,
某个特定智能体的执行延迟也不会拖慢其他智能体——进而不会阻碍整个GPU集群的运作。
4. 放弃Chiplet回归单芯片:保守选择背后的激进逻辑
Vera CPU采用了单一单片晶圆(Monolithic Die)设计。这一选择看似逆行业当前潮流而行。
AMD的EPYC处理器采用的是Chiplet(小芯片)架构。将大芯片切分为小晶片,在封装基板上通过互连总线拼装在一起。这种方式的优势显而易见:
良品率更高。
单颗成本更低。
无需做大单颗Die就能堆叠更多核心。
-> 这正是AMD追赶并反超英特尔的核心利器。
然而,Chiplet架构存在隐性代价。
当数据跨越不同的硅片区域时,会产生微小的延迟。
尽管延迟仅在纳秒级别,但在智能体AI高密度的编排调度中,这些延迟累积起来就会成为不可忽视的性能瓶颈。
单芯片架构则彻底消除了这一问题。
所有核心都集成在同一块硅片上,物理距离造成的传输延迟波动被彻底抑制。
88个奥林匹斯核心通过**“第二代可扩展一致性互联网格(SCF)”**连接。
即便某个核心需要访问晶圆对侧的缓存或I/O接口,横跨整个Die的通信仍能享有统一恒定的速率——双向对等带宽高达3.4 TB/s。
而在内存方面,Vera又做出了一项打破常规的抉择。
传统的服务器CPU均采用DDR5。这是行业标准,技术成熟且基础设施完善。
但在智能体AI工作负载下,DDR5的带宽上限和功耗成为了新的瓶颈。
顶级x86服务器CPU若想通过12通道以上的DDR5获得约600 GB/s的带宽,仅驱动内存总线就需要耗费100W以上的电力。
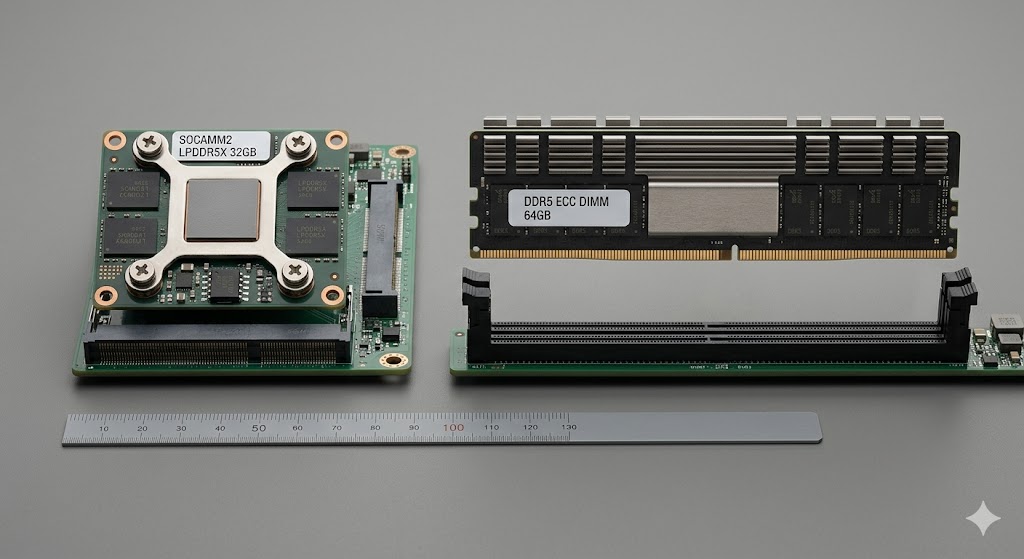
Vera选择采用了LPDDR5X。这原本是主打低功耗的移动端内存,英伟达将其移植到了服务器端,通过名为SOCAMM2的新型形态规格直接集成在服务器主板上。
最终实现了高达1.2 TB/s的内存带宽,达到DDR5的两倍;而功耗不足30W,仅为DDR5的三分之一。
这节省出来的70W功耗,全部被重新注入到了计算核心的性能释放中。
5. 数据所揭示的事实
基准测试结果往往见仁见智。
然而,外媒Phoronix在英伟达总部实测的数据,在计算机硬件业界引发了巨大震动。
在单路配置、TDP 450W设定下的Linux内核源码编译测试中:
Vera CPU(88核):20秒完成。
128核服务器CPU耗时:40秒。
-> 核心数还不到对方的一半,速度却快了一倍。这意味着单核计算效率达到了4倍。
从更广泛的几何平均性能来看:Vera领先AMD EPYC 9575F(64核,Zen 5)10%,领先英特尔至强6980P(128核)达55%。
若将这些数据换算为能效比,画面会更加清晰。
英特尔与AMD在输出该级别性能时功耗均在500W以上。
而Vera在核心功耗450W搭配内存功耗30W的情况下达成了这一性能,单位能效比优势接近2倍。
这直接关乎数据中心的运营成本。
电力是数据中心运营成本的核心。相同的功耗实现双倍的性能,意味着在减半的空间和散热成本下,能够获得完全相同的算力输出。
这也正是超大规模云服务商首年便砸出200亿美元预订单的原因所在。
6. 然而仅靠一颗CPU还远远不够
即便Vera CPU的性能令人惊叹,但仅凭它自身仍无法彻底解决智能体AI面临的深层瓶颈。
这里存在第二个瓶颈:上下文内存(Context Memory)。
当智能体执行复杂任务时,上下文会不断堆叠。
历史对话、执行轨迹、中间产物*——这些数据被称为“KV缓存(Key-Value Cache)”*。
如果智能体需要跨越数天持续执行任务,这个KV缓存会膨胀到数十甚至数百GB。
这些数据该存放在哪里?
放在GPU内部的HBM显存中最快。
但HBM成本极高且容量有限。如果将显存塞满KV缓存,用于实际推理计算的空间就会被大幅压缩,造成极大浪费。
但如果将其卸载到普通SSD中,下次调用时读取耗时太长,对话流的高速响应就会被瞬间打断。
这就是所谓的**“上下文内存存储墙”**。
为了解决这一难题,英伟达设计了名为G3.5的全新内存层级。
传统内存层级通常被理解为:
CPU寄存器 → L1/L2/L3缓存 → DRAM → SSD → HDD。越靠近顶端速度越快、成本越高、容量越小;越往下越慢、越便宜、容量越大。
G3.5正是插入在DRAM与SSD之间的全新层级。
它是一块通过以太网直连的专用闪存区域,速度慢于DRAM但远快于普通SSD。这便是CMX(Context Memory eXtension)。
当智能体完成一次任务、GPU转向处理下一个请求时,之前的KV缓存会自动从HBM移入CMX中。当同一个用户再次发起交互时,在实际推理开始之前,数据就会被抢先从CMX预加载回GPU显存中。
负责这一预加载调度的是NIXL(英伟达推理传输库,NVIDIA Inference Transfer Library)。
而决定将请求路由至哪个节点(即用户此前上下文物理距离最近的节点)的,则是Grove负载均衡器。
实测表明,CMX + NIXL + Grove三者的结合,相比传统基础设施将实时Token生成的吞吐率最高提升了5倍。
5倍确实是个亮眼的数据,但更重要的是其展现的战略方向:
英伟达不仅仅是在制造更快的芯片,而是在用自研架构全面重构AI基础设施的软硬件全栈。
7. Vera Rubin NVL72:将整个数据中心化作单颗芯片
Vera CPU固然可以单独销售,但其真正的使命在别处。
“Vera Rubin NVL72”——这个名字已经成为2025年AI基础设施业界被提及频率最高的词汇之一。
NVL72是一个单机架集成系统,机架内部包含:
72颗Rubin GPU、
36颗Vera CPU、
BlueField-4 DPU、
ConnectX-9 SuperNIC、
NVLink 6交换机、
Spectrum-6以太网交换机,
以及2025年12月斥资200亿美元收购的Groq所研发的LPU。
共计7种芯片。英伟达将这一理念称为**“极致协同设计(Extreme Co-design)”**。
其核心意义在于不再单独设计芯片而后进行拼凑,而是从一开始就把整个机架当作单台计算机来进行整体架构设计。
NVLink-C2C互连技术以1.8 TB/s的速率连接CPU与GPU,比PCIe Gen 6快7倍。-> 在这种带宽下,CPU与GPU之间的数据传输延迟再也不会导致GPU出现空转。
审视Rubin GPU本身的规格:台积电3纳米制程、3360亿个晶体管、288GB HBM4显存、22 TB/s显存带宽。单芯片推理算力达50 PFLOPS——是Blackwell的5倍。
再看Groq LPU。这是一款基于独特哲学设计的芯片。
为了消除GPU在与大容量HBM显存频繁通信时产生的总线瓶颈,Groq将芯片Die的大部分面积都塞满了超高速SRAM。
片上集成约500MB高速SRAM,内存带宽高达80 TB/s。配合确定性编译器,能够提前精确规划所有计算的时序,从而在硬件层面上彻底免除了复杂的分支预测机制。
这种特性(能够极其迅速地按顺序生成Token的Decode阶段)在什么场景下最显威力?
要理解NVL72机架的推理流程,需要将LLM推理拆解为两个阶段:
**预填充阶段(Prefill):**一次性处理输入Prompt的阶段,需要庞大的并行矩阵算力,由Rubin GPU全权负责。
**解码阶段(Decode):**在首个Token输出后,逐字顺序生成后续内容的阶段。该阶段呈严格的顺序性且对内存带宽极度敏感,由Groq LPU负责。
-> 当Rubin完成预填充后,计算上下文立即移交至Groq LPU。
Groq凭借80 TB/s的SRAM带宽以极高速度生成后续Token。
这种计算分流使得Vera Rubin NVL72在运行万亿参数大模型时,单位功耗下的推理吞吐量相比Blackwell提升了整整35倍。
35倍——所有人都能意识到,这早已超越了常规意义上的世代迭代范畴。
8. 2000亿美元的市场版图宣言
黄仁勋在GTC 2025上算了一笔账:全球现有约10亿台通用PC,每台PC中都配有一颗CPU;既然人类工作使用的设备需要CPU,那么AI智能体工作运行的基础设施中同样需要CPU。
按照黄仁勋的论述,未来将有数百亿个AI智能体,每个智能体都需要由CPU为其提供独立的沙箱运行环境。如果英特尔与AMD垄断数十年的市场格局发生重塑,这块释放出的市场真空规模将达到2000亿美元。
这番话或许包含战略层面的宣发成分,但首年即斩获200亿美元预订单却是实打实的数据。
英特尔2024年数据中心与AI部门的全年营收为128亿美元,而Vera CPU在问世首年便超越了这一数字。
然而,随之而来的一个更关键的问题是:
英伟达做CPU,为何会对英特尔和AMD构成如此巨大的威胁?
英伟达本质上是一家GPU公司,自己涉足CPU,不就只是市场上多了一家竞争对手而已吗?
这种认知存在偏差,原因如下。
英伟达的Vera CPU固然可以单独销售,
但当它被深度集成至NVL72机架中时,所展现出的是一套完全不同的价值主张。
采用这款CPU,与GPU的互连速度提升7倍,
与CMX的联动实现最佳匹配,
DOCA Memos软件栈得以无缝高速运转。
一旦脱离英伟达生态系统,用户将无法享受到任何这一层级的协同优化红利。
这就是垂直整合的本质。CPU本身并非最终目的,而是封死客户外逃出路的铁楔。
在此之前,超大规模云厂商尚有选择空间:
即便GPU不得不向英伟达采购,CPU依然可以选择AMD或者自研芯片。
这是云巨头们保住底层基础设施控制权的最后堡垒。而如今,NVL72直接将炮口对准了这座堡垒。
9. 来自三个方向的阻击
面对英伟达的步步紧逼,行业阻击力量自然从三个方向同时涌现。
Arm与Meta联盟
2025年,Arm首席执行官雷内·哈斯(Rene Haas)携手Meta基础设施团队联合发布了**“AGI CPU”参考架构**。
(单封装集成136个旗舰级“Neoverse V3”核心,功耗控制在300W以内。在常规风冷机架中,单机架即可部署8160个物理核心。)
其核心诉求是:无需英伟达那套严苛的高温液冷设施,依托开放架构同样能够实现极高的核心计算密度。
每吉瓦投资成本最高可削减100亿美元。
这打的不是纯技术超越牌,而是经济独立牌:
证明即便不被英伟达深度绑定,业界依然能够满足智能体编排调度对核心密度的苛刻要求。
三大云巨头自研芯片提速
谷歌的Axion、亚马逊的Graviton 5以及微软的自研芯片,
各大巨头都在全力提速,试图用自研芯片替代外购商用CPU来承载自身服务的编排调度负载。
亚马逊Graviton与Nitro混合系统的年化营收已突破200亿美元大关。
谷歌则宣称Axion相比现有方案性价比提升65%,能效提升60%。
它们的策略非常直接:
以自身的云服务体量为后盾,削减向英伟达支付的采购溢价,并将这部分省下的成本转化为对云客户的降价优势。
地缘政治与监管逆风
黄仁勋在台北电脑展(COMPUTEX)期间坦言,2000亿美元的潜在市场空间(TAM)预测中包含了中国市场的需求。
然而美国商务部的出口管制彻底切断了高端芯片直供中国的渠道。
与此同时,中国正大力扶持本土AI生态,持续推进去美国化半导体采购方针。
此外,英伟达耗资200亿美元收购Groq的交易模式也引发了争议。
这种通过“技术授权协议叠加团队吸收”的事实并购模式,被质疑涉嫌规避FTC反垄断审查。参议员爱德华·马基(Edward Markey)和伊丽莎白·沃伦(Elizabeth Warren)已正式致函要求展开调查。
这三股阻击力量究竟能在多大程度上放缓英伟达的扩张步伐,目前仍是一个悬而未决的课题。
10. 当垄断达成时会发生什么
计算机发展史上存在着某种周期性规律:
当垂直整合创造出极致的性能鸿沟时,
-> 大多数人会在绝对的性能优势面前选择妥协与依附。
-> 而当这种依附深重到一定程度时,开放生态的反击便会拉开帷幕。
IBM大型机曾走过这条路,DEC的VAX曾走过这条路,英特尔与微软构筑的Wintel帝国曾走过这条路,苹果的垂直整合亦是如此。
在每一个历史节点,垂直整合帝国都曾长期称霸。但每一次,开放生态最终都能找到帝国未曾掌控的疆域,抑或是攻入帝国因暴利而留下的高价真空地带。
但英伟达如今正在构建的版图,其规模远超以往任何时代。
将CPU、GPU、DPU、网络交换机、显存存储和软件栈全部纳入自家的垂直闭环,这不再是对某一单一产品品类的垄断,而是对整个计算基础设施全层级的绝对垄断。
有报道披露,即便是OpenAI和Anthropic内部,也已在深入讨论是否应当对全球推理算力全盘锁定在单一硬件供应商生态中表达担忧。
这种担忧究竟是未雨绸缪还是杞人忧天,唯有时间能给出答案。但担忧情绪本身就是一个明确的信号:行业在屈服于极致性能之前,已经开始严密权衡受制于人的长远代价。
现在的英伟达已经不再是一家单纯兜售GPU的公司。
它正试图成为智能体AI时代整个计算基础设施的唯一定义者。而Vera CPU,正是这一庞大野心最直白的宣告。
11. 基础设施新规则的重写
不妨退后一步,跳出细节来看。
我们当下究竟在见证着什么?
英伟达Vera CPU固然是一颗极为出色的芯片,但仅凭这一点还不足以说明这篇故事的重要性——市场上永远不缺更快的CPU。
这件事之所以举足轻重,是因为这颗芯片成为了AI基础设施底层设计逻辑正在被全盘颠覆的标志性证据。
传统的设计原则是:
在通用CPU之上挂载AI加速卡。
通过通用总线进行互连。
在通用存储设备中存放数据。
每一个层级彼此解耦且随时可被替换。
而全新的设计原则则是:
紧密围绕AI工作负载的特性,对所有层级进行全盘协同设计。
极致优化优先于通用可替换性。
而这种优化的定义权与控制权,被唯一一家供应商彻底垄断。
这一演进代表着一种底层哲学层面的碰撞:在开放系统的通用性与可替换性原则,同垂直整合的高效与极致优化原则之间,存在着旷日持久的张力。
这种博弈在AI时代迎来了全新的局面。
AI所渴求的极致算力门槛实在太高,以至于通用系统已经无法触及某些性能边界。而率先突破这道边界的人,便获得了通吃整个时代的入场券。
Vera CPU正是英伟达跨越这道边界的标志性一步。
无论这一举措最终成功与否,单是这种变革浪潮的开启本身,就正在重新书写整个计算基础设施的未来。
12. 智能体运转的世界
最后,换一个视角来审视这一切。
想象一下黄仁勋所描绘的那个“拥有数百亿AI智能体”的未来世界。
每一个智能体都在独立的沙箱中运转,拥有独立的记忆空间,调用着各自独立的工具。
它们宛如人类员工一样承接特定任务、推进进度、汇报产出,并等待下一项任务的下达。
在这样一个世界里,CPU究竟扮演着什么角色?它是为智能体提供独立思考的底层空间,-> 是为它们提供使用工具的操作之手,是为它们读写记忆提供高速通路的枢纽。
正如人类员工离不开工位和办公电脑一样,AI智能体同样一刻也离不开CPU。
英伟达打造Vera CPU,绝非仅仅为了填补某块市场空白,
而是一份旨在从零构筑智能体AI时代全新计算基础设施的宣战书。
在这份宣言面前,英特尔与AMD当下的立足点何在?
Arm、谷歌与亚马逊又在暗中筹备着怎样的反击?
而这一切博弈交织的最终结果,又将如何深远地重塑AI智能体的能力上限与使用成本?
这,才是这场在GPU幕后悄然打响的战争的真正全貌。
参考文献
- NVIDIA Corporation, “Vera Rubin Platform Architecture Whitepaper” (Jensen Huang, 2025)
- Michael Larabel, “NVIDIA Vera CPU Benchmarks on Linux,” Phoronix (2025)
- Jonathan Ross, “A Software-Defined Tensor Streaming Processor for Large-Scale Machine Learning,” Groq Inc.
- Arm Editorial Team, “Arm Everywhere: Accelerating Agentic AI in Modern Datacenters” (Rene Haas, 2025)
- Vincent Hsu, “IBM Storage Scale integration with NVIDIA Dynamo Serving Engines,” IBM Systems Group (2025)
- NVIDIA Developer Documentation, “DOCA Memos API Reference Guide” (2025)
- NVIDIA Research, “Agentic AI Orchestration Bottleneck Analysis: CPU vs GPU Latency Distribution” (2024)
- Tom’s Hardware, “NVIDIA Vera CPU vs Intel Xeon 6980P vs AMD EPYC 9575F: Benchmark Comparison” (2025)
- IEEE Computer Architecture Letters, “Spatial Multithreading for Agentic Workloads: Design Principles and Performance Analysis” (2025)
- Semiconductor Engineering, “SOCAMM2 Form Factor: Enabling LPDDR5X in Server Environments” (2025)
- Next Platform, “Understanding NVIDIA’s CMX Context Memory Extension Architecture” (2025)
- Hot Chips 37, “NVIDIA Olympus Microarchitecture Deep Dive” (2025)
- Solidigm Technical Brief, “D7-PS1010 NVMe SSD for AI Inference KV Cache Workloads” (2025)
- Reuters, “U.S. Senators Request FTC Investigation into NVIDIA-Groq Acquisition Structure” (2025)
- Dylan Patel, “The Agentic AI Infrastructure Wars: CPU, Memory, and the Battle for the Control Plane,” SemiAnalysis (2025)