
NVIDIAがCPU市場に参入した。
しかし、誰もそれを奇異だとは思わない。
2025年3月、ジェンスン・フアンはGTCの壇上でVera CPUを発表し、こう語った。
「私たちは今、AIファクトリーを創り出している。」
聴衆は拍手を送った。だが、その発表の裏に隠されていた真の宣言は別にあった。
世界最大の半導体企業が、数十年にわたりIntelとAMDの独占領土であったデータセンター向けCPU市場へ正面から歩みを進めたということだ。翌日、Intelの株価は3.2%下落した。AMDは1.8%下落した。それだけだった。数日後、ニュースは別の話題で埋め尽くされた。
しかし、静かに示された一つの数字がある。
Vera CPUの発売初年度、予約注文額は200億ドルを突破した。
Intelの2024年データセンター部門の年間売上高が128億ドルであったことを考慮すれば、これは単なる新製品の発売ではなかった。何かが変わりつつあった。それも、根本的に。
1. 私たちが見落としていたボトルネック
過去5年間のAIインフラ戦争のシナリオは単純明快だった。
GPUが重要である。
より多くのVRAM、より高いFLOPS、より高速な接続。H100、A100、Blackwell。何兆円もの投資がその方向だけに注ぎ込まれた。
しかし、2024年から奇妙な事象が観測され始めた。
データセンターの運用者たちがGPUクラスタの実際の稼働率を測定し始めると、不都合な数字が浮き彫りになった。
エージェンティックワークフロー——複数のステップを自律的に計画し、ツールを呼び出し、コードを実行するAIシステム——において、GPUの実質的な演算稼働率が期待値の半分にも満たないということだった。
GPUは休んでいた。待ちながら。
何を待っているのか。 -> CPUの処理を待っているのだ。
これは単なるボトルネックではなかった。アーキテクチャの亀裂だった。
-> そしてNVIDIAは、この亀裂を3年前から見抜いていた。
エージェンティックAIが動作する仕組みを考えてみよう。
ユーザーが「この契約書を分析し、関連判例を検索して、要約レポートを作成してほしい」と入力すると、
AIは単にテキストを生成するだけではない。
計画を立てる。 -> ツールを選択する。 -» APIを呼び出す。 -> 結果を解釈する。 -> 次のステップを決定する。
このすべてのオーケストレーションは、GPUではなくCPUで行われる。
問題は、このオーケストレーションの比重が急速に増大していることだ。
ツールの呼び出し比率が極端に高いエージェントワークフローでは、全レイテンシの50%から最大88%までがCPUのツール処理遅延から発生しているという分析が示された。
残りの12%から50%が、GPUで処理される実際の推論である。
数兆円規模のGPUクラスタが、半分以上の時間を汎用CPUの処理完了を待つアイドル状態で過ごしていたのだ。
これこそがNVIDIAの見ていた光景だった。そしてNVIDIAは、そのボトルネックを自らの手で埋めることを決めた。
2. エージェンティックAIが変えた演算の文法
チャットボットとエージェントの間の距離は、想像以上に遠い。
チャットボットは入力を受け取り、単方向の変換によって出力を返す。
その演算の本質は巨大な行列乗算であり、これはGPUが得意とする領域だ。
トークンを並列処理し、重みを掛け合わせ、次のトークンを予測する。
この過程において、CPUの役割は指示を伝達し、結果を受け取る管理者程度に最小化される。
エージェントは異なる。
エージェントが単一のユーザー要求を処理する間に、チャットボットと比較して最低15倍以上のトークンが生成される。
理由は単純だ。
エージェントは決定を下すごとに内部独白(モノローグ)を記述する。
「現在の状況はこうだ。次にすべきことはあれだ。このツールをこのように呼び出す。」
この計画-実行-検証のループが繰り返され、コンテキストが爆発的に増大する。
さらに重要なのは、その15倍の処理が均一ではないという点だ。
エージェントが処理する演算の多くは逐次的であり、分岐が複雑で、予測不可能である。
どのAPIを呼び出すか、その結果をどう解釈するか、エラーが発生した場合にどのルートで復旧するか——これらすべての制御フローは、並列処理に最適化されたGPUではなく、複雑な分岐予測と逐次実行に強みを持つCPUの領域である。
これこそが演算環境の構造変化だ。
AI演算の中心が***「巨大な並列行列演算」から「複雑な逐次制御 + 巨大な並列演算の反復的な組み合わせ」へとシフト***している。
ここでデータセンターの設計に重大な示唆が生じる。
従来のAI学習および推論データセンターは、ギガワットあたり約3,000万個の汎用CPUコアで運用する構造だった。
エージェンティック推論のオーケストレーション負荷を支えるためには、この密度をギガワットあたり1億2,000万コア水準へと——約4倍に——引き上げなければならないという分析が出された。
単により多くのCPUが必要になったわけではない。
CPUが果たす役割の性質そのものが変化したのだ。
汎用演算処理装置から、AIオーケストレーションに特化した高密度制御インフラへ。
そして、その役割に合わせて設計されたCPUは、これまで存在しなかった。
3. Olympus:汎用性を拒絶した設計
NVIDIAが以前に開発したGrace CPUを覚えているだろうか。
2023年リリース。Arm Neoverse V2コアベース。静かに登場し、静かに使われた。
Graceはすでに検証済みのコアを採用する安全なアプローチとして、Armの既成設計をライセンス供与されて搭載していた。
Veraは異なる。
Veraの中核は「Olympus(オリンパス)」カスタムコアだ。
NVIDIA史上初となる自社設計のCPUコアであり、Armv9.2命令セットと互換性を持ちながらも、内部構造は完全にゼロから構築された。
なぜゼロから作り直したのか。
この問いに対する答えが、Veraの設計思想全体を説明している。
汎用CPUコアは、多様なワークロードを処理できるように設計される。ワードプロセッサも、データベースも、ゲームも、コンパイラも。この汎用性のために、分岐予測器は一般的なコードパターンに最適化される。キャッシュ構造は多様なメモリアクセスパターンに対応するように設計される。
エージェンティックAIが実行するコードは、この「一般的」なパターンから極端に逸脱している。Python仮想マシン、仮想化サンドボックスツール、分散データベースクエリスケジューラ——これらは不規則で激しく入り組んだ制御フローを生み出す。
汎用分岐予測器の誤予測が増加し、パイプラインストールが頻発する。
Olympusコアの分岐予測器と命令デコーダパイプラインは、このパターンに合わせてカスタマイズされた。
不規則な逐次コードフローを最短レイテンシで解釈・処理するように設計されている。その結果、従来のGraceコアと比較してクロックあたりの命令実行数(IPC)が1.5倍向上した。
しかし、Olympusのさらに興味深い革新は**「空間的マルチスレッディング(Spatial Multithreading)」**にある。
Intelのハイパースレッディングをご存知なら、これが何であるかを理解するのは容易だ。そして、なぜそれだけでは不十分なのかも理解できる。
ハイパースレッディングは、1つの物理コアを、一方のスレッドがメモリを待つ間にもう一方のスレッドが実行されるという形で、2つの論理スレッドが時分割で共有する。
しかし、2つのスレッドが同時に計算を必要とする状況——エージェントが同時に2つのツールを呼び出して結果を処理するような場面——になると、
演算ユニットを巡って競合が発生する。ジッター(Jitter)が生じ、応答時間が不規則になる。
Olympusの空間的マルチスレッディングは別のアプローチを採用した。
88個の物理コア内部の演算リソースを、ハードウェアレベルで2つの完全に独立した区画へ恒久的に分割する。
176個の仮想スレッドは、互いのリソースを侵食することができない。
個別の物理スレッドレベルの性能が一貫して保証される。
何千もの独立したエージェントが同時にコンパイラを呼び出し、サンドボックスを起動したとしても、
特定のエージェントの実行遅延が他のエージェント——さらにはGPUクラスタ全体——の処理を阻害することはない。
4. チップレットではなくモノリシック:保守的な選択の先鋭的な理由
Vera CPUは単一のモノリシックダイ(Monolithic Die)設計を採用した。これは昨今のトレンドに逆行する選択である。
AMDのEPYCプロセッサはチップレット構造だ。大きなダイを小さく分割し、パッケージ基板上でインターコネクトによって結合する。この方式のメリットは明白だ。
歩留まりが向上する。
コストが下がる。
ダイサイズを極端に大型化することなくコア数を増やせる。
-> AMDがIntelを追撃し、追い越す原動力となった武器がまさにこれだった。
しかし、チップレット構造には隠れたコストが存在する。
異なるシリコンピース間をデータが通過するたびに、微細な遅延が発生する。
ナノ秒単位の遅延ではあるが、エージェンティックAIのオーケストレーションにおいては、これが累積することで無視できないボトルネックとなる。
モノリシックダイではこの問題が存在しない。
すべてのコアが同一のシリコン上に存在する。物理的距離による伝送遅延のばらつきが完全に制御される。
88個のOlympusコアは、**「第2世代スケーラブル・コヒーレンシ・ファブリック(SCF)」**で接続されている。
コアがダイの反対側にあるキャッシュや入出力端子にアクセスしても、ダイ全体を横断する通信に一貫した速度である毎秒3.4TBの二分割帯域幅を提供する。
そしてメモリ。ここでVeraはもう一つの常識破りな選択を下す。
従来のサーバー向けCPUはDDR5を使用する。標準規格であり、実績があり、インフラが整っている。
しかし、DDR5の帯域幅の限界と消費電力は、エージェンティックワークロードにおいてボトルネックとなる。
最上位のx86サーバーCPUは、12チャネル以上のDDR5によって毎秒600GB水準の帯域幅を確保するために、メモリバスの駆動だけで100W以上を消費する。
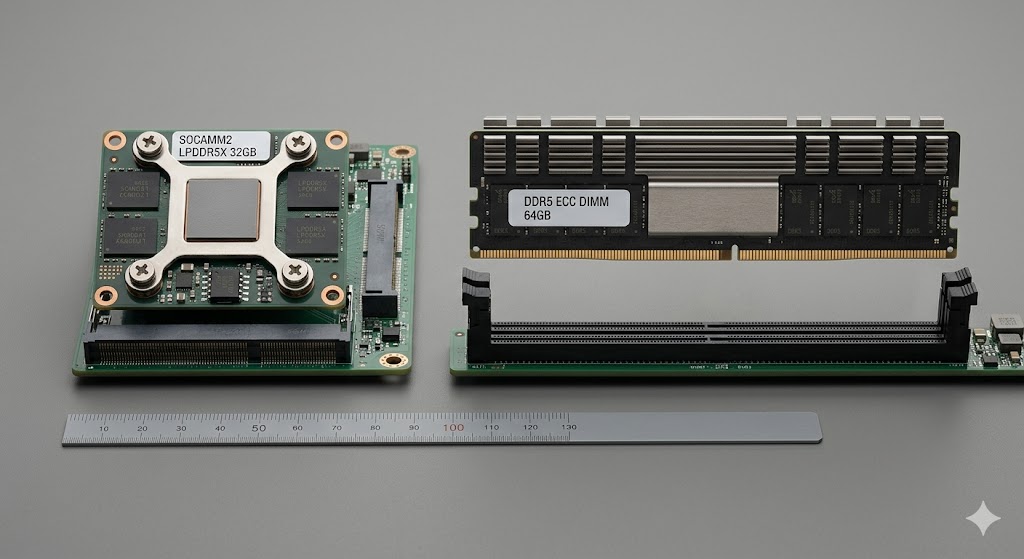
VeraはLPDDR5Xを選択した。本来は低消費電力が強みであるモバイル機器向けメモリだ。それをサーバーに移植した。SOCAMM2という新しいフォームファクタにより、サーバーマザーボードに直接搭載した。
その結果、毎秒1.2TBのメモリ帯域幅を実現。DDR5の2倍だ。消費電力は30W未満。DDR5の3分の1水準である。
この削減された70Wが、演算コアのパフォーマンスへと還元される。
5. 数字が物語る真実
ベンチマークには議論の余地がつきものだ。
しかし、PhoronixがNVIDIA本社で実測したデータは、コンピュータハードウェア業界に大きな衝撃を与えた。
シングルソケット構成、TDP 450W設定。Linuxカーネルソースコードのコンパイルテストにおいて、
Vera CPU(88コア):20秒で完了。
128コアのサーバーCPUが要した時間:40秒。
-> コア数は半分以下であるにもかかわらず、速度は2倍。コアあたりの演算効率が4倍であることを意味する。
より広い視野で見ると、幾何平均パフォーマンスにおいてVeraはAMD EPYC 9575F(64コア、Zen 5)を10%上回り、Intel Xeon 6980P(128コア)を55%上回った。
これらの数字を電力効率に換算すると、構図はより明瞭になる。
IntelとAMDは500W以上の電力を消費してこの性能を出している。
Veraは単位電力あたり性能で約2倍の優位性を誇り、450Wにメモリ電力30Wという構成でその性能を発揮する。
そしてこれが、データセンターの運用コストに直結する。
電力は運用コストの中核だ。
同じ電力で2倍の性能が得られるなら、同等の性能を半分のスペースで、半分の冷却コストで獲得できることを意味する。
ハイパースケーラーたちが200億ドルを事前発注した理由がここにある。
6. だが、CPU単体では不十分だ
Vera CPUの性能がいかに圧倒的であっても、それ単体ではエージェンティックAIの根本的なボトルネックを解消することはできない。
第2のボトルネックが存在する。コンテキストメモリだ。
エージェントが複雑なタスクを実行すると、コンテキストが蓄積される。
過去の対話、実行履歴、中間生成物——*これらを「KVキャッシュ(Key-Value Cache)」*と呼ぶ。
エージェントが数日間にわたって作業を継続すると、このKVキャッシュは数十から数百ギガバイトへと膨れ上がる。
これをどこに保管するのか。
GPU内部のHBMメモリに配置すれば最も高速だ。
しかし、HBMは高価であり容量に限りがある。その領域をKVキャッシュで埋めてしまえば、実際の推論に使えるメモリが減少する。無駄が生じるのだ。
かといって一般的なSSDに退避させれば、次回読み出す際に時間を要する。スムーズな会話のフローが寸断されてしまう。
これが**「コンテキストメモリストレージの壁」**である。
そしてNVIDIAは、これを解決するためにG3.5と呼ばれる新たなメモリ階層を設計した。
メモリ階層は通常、次のように捉えられる。
CPUレジスタ → L1/L2/L3キャッシュ → DRAM → SSD → HDD。高速であるほど高価で小容量。
低速であるほど安価で大容量。
G3.5はこの階層の間に割り込む。
DRAMよりは遅いが一般的なSSDより遥かに高速な、Ethernetで接続された専用フラッシュメモリ領域。これが**CMX(Context Memory eXtension)**だ。
エージェントがタスクを完了し、GPUが次のリクエストを処理している間に、直前のKVキャッシュはHBMから自動的にCMXへと移行される。同一ユーザーが再接続すると、実際の推論が開始される直前にCMXからGPUメモリへ先回りしてロードされる。
このプリローディングは**NIXL(NVIDIA Inference Transfer Library)**が担当する。
そして、どのノードへリクエストをルーティングすべきか——ユーザーの直前のコンテキストが物理的に最も近いノード——は、Groveロードバランサーが決定する。
これら3つの要素——CMX + NIXL + Grove——の組み合わせにより、従来のインフラと比較してリアルタイムトークン生成スループットが最大5倍向上するという測定結果が得られた。
5倍という数値は強烈だ。だが、より重要なのはその方向性である。
NVIDIAは単により高速なチップを作ったのではなく、AIインフラのソフトウェアとハードウェアスタック全体を自社の設計へと置き換えようとしているのだ。
7. Vera Rubin NVL72:データセンターを1つのチップのように
Vera CPUは単体で販売されることもあるが、その真の狙いは別の場所にある。
「Vera Rubin NVL72」。この名称は、2025年のAIインフラ業界で最も頻繁に言及される言葉の一つとなった。
NVL72は単一の統合ラックである。このラック内に収められているのは以下の構成だ。
72基のRubin GPU。
36基のVera CPU。
BlueField-4 DPU。
ConnectX-9 SuperNIC。
NVLink 6スイッチ。
Spectrum-6 Ethernetスイッチ。
2025年12月に200億ドルで買収したGroqのLPU。
計7種類のシリコン。これらをNVIDIAは**「エクストリーム・コデザイン(Extreme Co-design)」**と呼ぶ。
個別のチップを設計して組み合わせるのではなく、ラック全体を単一のコンピュータのように最初から一括設計するという意味だ。
NVLink-C2CインターコネクトがCPUとGPUをPCIe Gen 6の7倍高速な毎秒1.8TBの速度で接続する。 -> この広大な帯域幅により、CPU-GPU間のデータ転送遅延によってGPUがアイドル状態に陥る事態は排除される。
Rubin GPUのスペックを見れば、TSMC 3nmプロセス、3,360億個のトランジスタ、288GBのHBM4メモリ、毎秒22TBの帯域幅。単一チップの推論性能は50ペタフロップス(PFLOPS)——Blackwell比で5倍の性能を誇る。
そしてGroq LPU。Groqは独自の哲学に基づいて設計されたチップだ。
GPUが大容量HBMメモリと頻繁に通信する際に生じるバスのボトルネックを解消するため、シリコンダイの大部分を高速SRAMで満たした。
約500MBのオンチップSRAM、毎秒80TBのメモリ帯域幅。そして決定論的コンパイラがすべての演算のタイミングを事前に完全にスケジューリングし、ハードウェアレベルの複雑な分岐予測を不要にするアーキテクチャを実行する。
この特性(トークンを逐次的に、高速に生成するデコード段階)は何に強いのか。
NVL72ラックの推論フローを理解するには、LLM推論を2つのフェーズに分ける必要がある。
**プリフィル(Prefill):**入力プロンプトを一括処理するフェーズ。大規模な並列行列演算が求められる。Rubin GPUがこれを担当する。
**デコード(Decode):**最初のトークンが出力された後、単語を1つずつ順番に生成していくフェーズ。逐次的でありメモリ帯域幅に極めて敏感だ。Groq LPUがこれを担当する。
-> Rubinがプリフィルを完了すると、演算コンテキストがGroq LPUへと移管される。
Groqの80TB/sに達するSRAM帯域幅が、光速のスピードでトークンを生成し続ける。
この機能分離の結果、Vera Rubin NVL72はBlackwellと比較して、兆パラメータ(Trillion Parameter)モデルにおいて電力あたりの推論スループットが35倍向上した。
35倍。これが単なる世代交代レベルの数値ではないことは、誰の目にも明らかだ。
8. 2,000億ドルの領土宣言
ジェンスン・フアンはGTC 2025において、現在世界には約10億台の汎用PCが存在する、それぞれのPCにはCPUがある、人間が作業する端末にCPUが必要であるように、AIエージェントが稼働するインフラにもCPUが必要である、と試算を展開した。
ジェンスン・フアンの宣言によれば、数百億ものAIエージェントが存在し、それぞれに独立したサンドボックス演算を提供するCPUが必要となる。IntelとAMDが数十年にわたり独占してきた市場構造が変革されるとすれば、その空白領域の規模は2,000億ドルに達する。
誇張に聞こえるかもしれないが、初年度に200億ドルの事前発注が集まったのは厳然たる事実だ。
Intelの2024年のデータセンター&AI部門の年間売上高は128億ドルであった。Vera CPUは初年度にしてすでにそれを上回った。
しかし、ここでさらに重要な疑問が浮かび上がる。
NVIDIAがCPUを作ることが、なぜIntelやAMDにとって致命的な脅威となるのか?
NVIDIAはGPUの企業だ。CPUを新たに開発したところで、競合が1社増えるだけに過ぎないのではないか。
その認識が誤りであるのには理由がある。
NVIDIAのVera CPUは単体で販売されることも可能だが、
それがNVL72の中に統合されたとき、まったく異なる価値提案へと変貌する。
そのCPUを使えばGPUとの接続が7倍高速化され、
CMXとの連携が最適化され、
DOCA Memosソフトウェアスタックがシームレスに機能する。
NVIDIAエコシステムの外側では、この最適化の恩恵を享受することはできない。
これこそが垂直統合の本質である。CPUそれ自体が目的なのではなく、CPUは逃げ道を塞ぐための楔(くさび)なのだ。
ハイパースケーラーたちには、これまで選択肢があった。
GPUはやむを得ずNVIDIAから購入するとしても、CPUはAMDや自社設計のチップを採用してきた。
これこそがインフラ支配権の最後の砦だった。だが今、NVL72はその砦を正面から標的に定めている。
9. 3つの方向からの抵抗
当然ながら、この攻勢に対して3つの方向から同時に激しい抵抗が生じている。
Arm-Meta同盟
ArmのCEOルネ・ハースは2025年、Metaのインフラチームと共同で**「AGI CPU」リファレンスアーキテクチャ**を発表した。
(フラッグシップコア「Neoverse V3」を単一パッケージに136基搭載。消費電力300W以下。一般的な空冷ラック環境において、単一ラック基準で8,160個の物理コアを運用可能。)
発信された中核メッセージ:NVIDIAのような高温液体冷却インフラを用いずとも、オープンアーキテクチャによってより高いコア密度を達成できる。
ギガワットあたりの設備投資コスト削減:最大100億ドル。
これは技術的優位性というよりも、経済的独立性を掲げた論理である。
NVIDIAによる垂直ロックインを回避しながら、エージェンティックオーケストレーションが求めるコア密度の需要を充足できるという主張だ。
クラウド大手3社による内製化の加速
GoogleのAxion。AmazonのGraviton 5。Microsoftの自社設計チップ。
各社は自社サービスのオーケストレーション負荷を、外部の商用CPUではなく自社シリコンで処理する方向へと内製化を加速させている。
Amazon GravitonとNitroハイブリッドシステムは、すでに年間売上高ランレート200億ドルを記録した。
Google Axionは、既存ソリューション比でコストパフォーマンス65%向上、エネルギー効率60%改善を謳っている。
彼らの戦略は明快だ。
自社クラウドサービスの巨大な規模を武器とし、NVIDIAへ支払うべきコストを圧縮して、その恩恵をクラウドユーザーへの値下げとして還元する。
地政学と規制の逆風
ジェンスン・フアンはCOMPUTEXにおいて、2,000億ドルのTAM予測に中国市場の需要が含まれていることを認めた。
しかし、米商務省による輸出規制は、ハイエンドチップセットの中国向け直接輸出ルートを遮断している。
中国は国内AIエコシステムの育成を強力に推し進め、米国製半導体の輸入猶予・排除の基調を強めている。
さらに、200億ドル規模のGroq買収手法も議論の的となった。
「ライセンス契約と人材採用を通じた実質的な買収合意」という手法が、FTC(連邦取引委員会)の企業結合審査を意図的に回避したのではないかという疑惑が浮上し、エドワード・マーキーやエリザベス・ウォーレンら上院議員が公式な調査を求めた。
これら3つの抵抗勢力が、NVIDIAの拡張スピードをどれほど減速させられるかは、いまだ予断を許さない。
10. 独占が完成するときに起きること
コンピューティングの歴史には一定のパターンが存在する。
垂直統合が究極のパフォーマンスを生み出すと、
-> その圧倒的な性能の前に、多数派は従属を選択する。
-> そしてその従属が十分に深まったとき、オープンエコシステムによる反撃が始まる。
IBMのメインフレームがそうだった。DECのVAXがそうだった。IntelとMicrosoftによるWintelがそうだった。Appleの垂直統合がそうだった。
いずれのケースでも、垂直統合の帝国は長期にわたり君臨した。しかしどのケースにおいても、帝国が掌握しきれなかった領域を、あるいは帝国が高価にしすぎた隙間を、オープンエコシステムは最終的に見つけ出してきた。
NVIDIAが現在構築しつつあるもののスケールは、過去の歴史とは一線を画している。
CPU、GPU、DPU、ネットワークスイッチ、メモリストレージ、そしてソフトウェアスタックを同時に垂直統合することは、単一製品領域の独占ではなく、コンピューティングインフラの全レイヤーに対する独占を意味する。
OpenAIやAnthropicの内部でさえ、特定のハードウェアベンダーのエコシステムに全世界の推論計算能力がロックインされることへの懸念が、内部議論として浮上しているとの報道がなされた。
それが正当な警告なのか取り越し苦労なのかは、時間が証明するだろう。しかし、この懸念自体が、圧倒的な性能の前に屈する前に、まず従属に伴うコストの計算を始めていることを意味する重要なシグナルだ。
NVIDIAはもはやGPUを売るだけの企業ではない。
エージェンティックAI時代におけるコンピューティングインフラ全体を設計する企業になろうとしている。Vera CPUは、その野望の最も明示的な宣言である。
11. 新たに書き換えられるインフラの文法
少し立ち止まって、俯瞰してみよう。
私たちは今、何の目撃者なのだろうか。
NVIDIA Vera CPUは極めて優れたチップである。しかし、それだけではこのストーリーが持つ重大性を説明しきれない。より高速なCPUは、いつの時代も登場し続けるからだ。
これが決定的に異なる理由は、このチップが*「AIインフラの設計原則そのものが変化している」という動かぬ証拠*だからである。
従来の設計原則はこうだった。
汎用CPUの上にAIアクセラレータを追加する。
汎用インターコネクトで接続する。
汎用ストレージにデータを保存する。
各レイヤーは独立しており、いつでも交換可能である。
新たな設計原則は異なる。
AIワークロードの特性に合わせて、すべてのレイヤーを一括設計する。
交換可能性よりも最適化を最優先する。
そして、その最適化の権限を単一のベンダーが独占する。
この転換は、コンピューティングインフラの汎用性と交換可能性というオープンシステムの原則と、最適化と効率という垂直統合の原則との間に横たわる、古くからの緊張関係の哲学的転換でもある。
その緊張が、AIの時代において新たな局面を迎えた。
AIが要求する極限のパフォーマンス水準があまりにも高すぎるため、汎用システムでは決して到達できない領域が出現した。そして、その領域に最初に到達した者が市場を掌握できる時代が到来したのだ。
Vera CPUは、その高みを目指す決定的な一手である。
そして、その試みが成功するか失敗するか以上に、そうした地殻変動がすでに始まったという事実そのものが、コンピューティングインフラの未来を書き換えている。
12. エージェントたちが働く世界
最後に、少し異なる視点から。
ジェンスン・フアンが語った「数百億のAIエージェント」を想像してみてほしい。
それぞれが独立したサンドボックスの中で、独立したメモリを持ち、独立したツールを駆使して稼働する。
人間の労働者のように特定のタスクを受け持って進め、結果を報告し、次のタスクを待機する。
この世界において、CPUとは何か。エージェントに思考するための空間を与えるものである。 -> ツールを操作するための手を与えることである。記憶を保存し、呼び出すための経路を提供することである。
人間の労働者にデスクとコンピュータが必要であるように、AIエージェントにはCPUが必要なのだ。
NVIDIAがVera CPUを開発したのは、市場の空白を埋めるためではない。
エージェンティックAI時代のコンピューティングインフラを、最初からすべて設計し直すという宣言なのだ。
その宣言を前にして、IntelとAMDは今どこに立っているのか。
Arm、Google、Amazonは何を準備しているのか。
そして、このすべての戦いの結末が、AIエージェントの能力とコストをどのように決定づけるのか。
それこそが、GPUの背後で今まさに静かに繰り広げられている戦争の真の姿である。
参考文献
- NVIDIA Corporation, “Vera Rubin Platform Architecture Whitepaper” (Jensen Huang, 2025)
- Michael Larabel, “NVIDIA Vera CPU Benchmarks on Linux,” Phoronix (2025)
- Jonathan Ross, “A Software-Defined Tensor Streaming Processor for Large-Scale Machine Learning,” Groq Inc.
- Arm Editorial Team, “Arm Everywhere: Accelerating Agentic AI in Modern Datacenters” (Rene Haas, 2025)
- Vincent Hsu, “IBM Storage Scale integration with NVIDIA Dynamo Serving Engines,” IBM Systems Group (2025)
- NVIDIA Developer Documentation, “DOCA Memos API Reference Guide” (2025)
- NVIDIA Research, “Agentic AI Orchestration Bottleneck Analysis: CPU vs GPU Latency Distribution” (2024)
- Tom’s Hardware, “NVIDIA Vera CPU vs Intel Xeon 6980P vs AMD EPYC 9575F: Benchmark Comparison” (2025)
- IEEE Computer Architecture Letters, “Spatial Multithreading for Agentic Workloads: Design Principles and Performance Analysis” (2025)
- Semiconductor Engineering, “SOCAMM2 Form Factor: Enabling LPDDR5X in Server Environments” (2025)
- Next Platform, “Understanding NVIDIA’s CMX Context Memory Extension Architecture” (2025)
- Hot Chips 37, “NVIDIA Olympus Microarchitecture Deep Dive” (2025)
- Solidigm Technical Brief, “D7-PS1010 NVMe SSD for AI Inference KV Cache Workloads” (2025)
- Reuters, “U.S. Senators Request FTC Investigation into NVIDIA-Groq Acquisition Structure” (2025)
- Dylan Patel, “The Agentic AI Infrastructure Wars: CPU, Memory, and the Battle for the Control Plane,” SemiAnalysis (2025)
参考文献
- Arm Editorial Team, "Arm Everywhere: Accelerating Agentic AI in Modern Datacenters" (Rene Haas, 2025)
- Vincent Hsu, "IBM Storage Scale integration with NVIDIA Dynamo Serving Engines," IBM Systems Group (2025)
- NVIDIA Developer Documentation, "DOCA Memos API Reference Guide" (2025)
- NVIDIA Research, "Agentic AI Orchestration Bottleneck Analysis: CPU vs GPU Latency Distribution" (2024)
- Tom's Hardware, "NVIDIA Vera CPU vs Intel Xeon 6980P vs AMD EPYC 9575F: Benchmark Comparison" (2025)
- IEEE Computer Architecture Letters, "Spatial Multithreading for Agentic Workloads: Design Principles and Performance Analysis" (2025)
- Semiconductor Engineering, "SOCAMM2 Form Factor: Enabling LPDDR5X in Server Environments" (2025)
- Next Platform, "Understanding NVIDIA's CMX Context Memory Extension Architecture" (2025)
- Hot Chips 37, "NVIDIA Olympus Microarchitecture Deep Dive" (2025)
- Solidigm Technical Brief, "D7-PS1010 NVMe SSD for AI Inference KV Cache Workloads" (2025)
- Reuters, "U.S. Senators Request FTC Investigation into NVIDIA-Groq Acquisition Structure" (2025)
- Dylan Patel, "The Agentic AI Infrastructure Wars: CPU, Memory, and the Battle for the Control Plane," SemiAnalysis (2025)