
歴史はしばしば、非常に些細で、時には取るに足らないように見える制約条件から、巨大な流れを変えてしまいます。
もしあなたが、2025年現在、世界時価総額トップを争う企業、NVIDIA(エヌビディア)が今日の栄光を享受するに至った決定的なきっかけは何だと問われたら、何と答えるでしょうか?
多くの人は、最新チップのH100やChatGPTの登場を思い浮かべるかもしれません。
しかし、その出発点はもっとはるかに質素で、劇的な瞬間にありました。
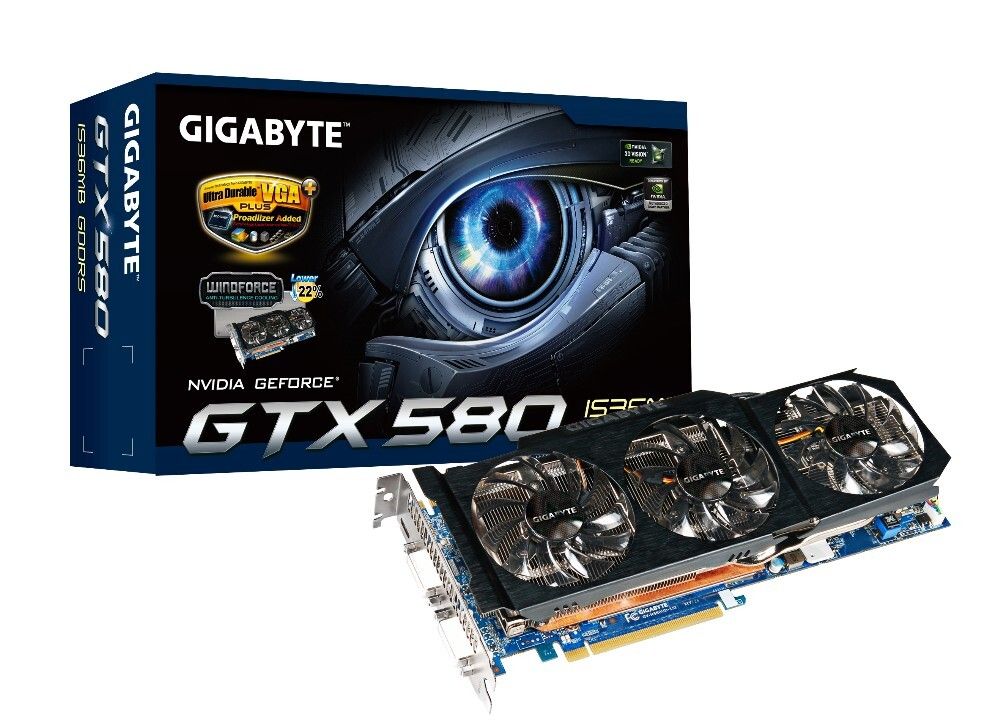
それは、2012年、龍山(ヨンサン)電子商街でもよく見かけた「GTX 580」グラフィックカードわずか2枚が放った小さな一石でした。
この記事は、数兆ウォンのスーパーコンピューターでも解決できなかった難題を「コストパフォーマンス」に優れた機器で解決し、**「ディープラーニングのビッグバン(The Big Bang of Deep Learning)」**を引き起こしたAlexNetの物語であり、
その炎を逃さず、森全体を燃え上がらせる巨大な炎へと育て上げたNVIDIAの偉大な共生に関する記録です。
1. プロローグ:2012年フィレンツェ、6日間の革命
2012年9月30日、イタリアのフィレンツェで開催されたコンピュータビジョン会議(ECCV)のワークショップ。そこにはいつもとは違う空気が流れていました。
当時、人工知能学界は数十年にわたる「AIの冬(AI Winter)」の中にありました。
コンピューターが猫の写真を見て「猫」と当てることさえ困難な時代でした。
ImageNetコンペティションでは、競合他社はエラー率26%という高い壁に打ちひしがれていました。
そんな中、トロント大学の**ジェフリー・ヒントン教授チーム(SuperVision)**が発表した結果は、衝撃そのものでした。
エラー率15.3%。
既存記録をあっという間に10パーセントポイント以上上回る圧倒的な数値でした。
さらに驚くべきは、彼らが使用した機器でした。
数百億円にもなる大学のスーパーコンピューターではなく、*わずか6日間、2つのコンシューマー向けGPU(GTX 580)を稼働させて得られた結果*だったからです。
この瞬間は、後にジェンセン・フアンによって「AIのビッグバン」と名付けられます。
2. 暗黒期:「猫」を認識できなかったスーパーコンピューター
2012年以前に時間を戻してみましょう。
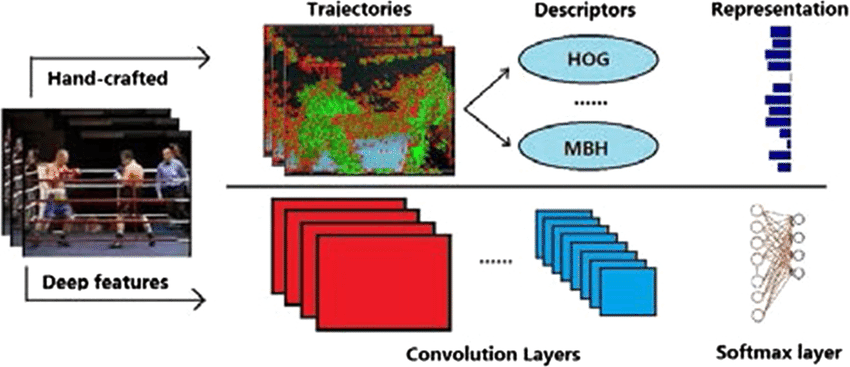
当時のコンピュータービジョン技術は、人間の直感に依存する**「手作業特徴量(Hand-crafted Features)」**方式が主流でした。
「猫は耳が尖っている。」
「目は楕円形だ。」
「ひげがある。」
研究者たちは、こうした規則を数学的に定義(SIFT、HOGなど)しようと試みました。しかし、現実は冷酷でした。
丸まった猫、後ろ姿しか見えない猫、暗闇に隠れた猫…人間が事前に入力していない変数に直面すると、アルゴリズムは為す術がありませんでした。
専門家たちはこれを、0と1でできたデータと実際の概念との間にある、渡ることのできない川、**「意味論的ギャップ(Semantic Gap)」**と呼んでいました。
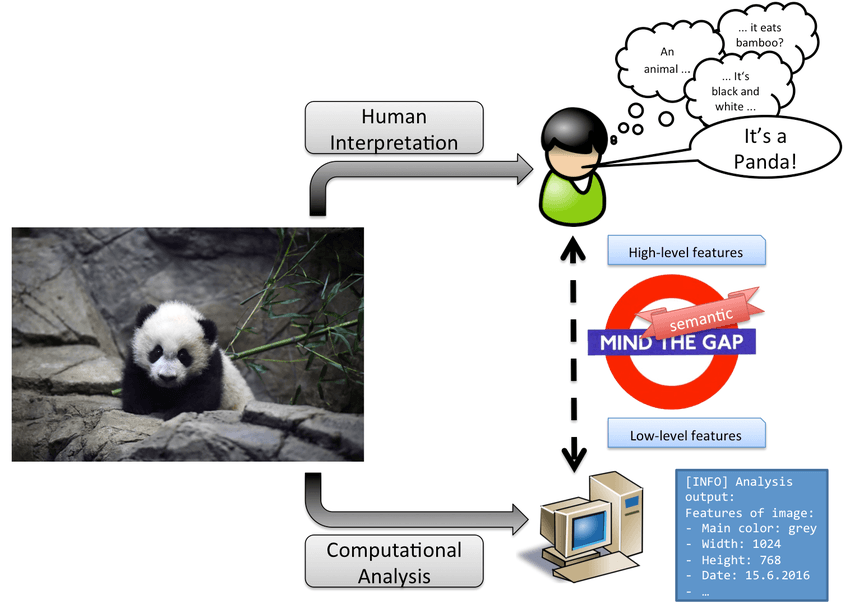
Googleですら16,000個のCPUコアを動員して猫の顔を探す実験を行いましたが、コストパフォーマンスは惨憺たるものでした。
NVIDIAも同様に、もどかしい状況でした。
2006年に野心的にGPUを汎用演算に使えるCUDA(クダ)プラットフォームをリリースしましたが、それをまともに活用できる「キラーアプリ」がなかったからです。市場は彼らを単なる「ゲーム用部品会社」としてしか見ていませんでした。
3. 欠乏が生んだ天才性:3GBメモリの限界を超える
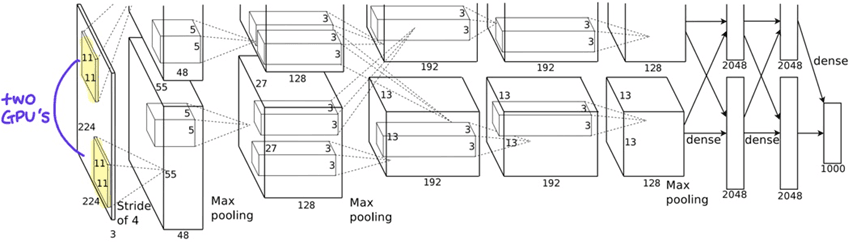
AlexNetの主著者であるアレックス・クリジェフスキー(Alex Krizhevsky)は、**ディープニューラルネットワーク(Deep Neural Networks)**こそが正解だと直感しました。
問題は演算量でした。貧しい大学院生が持つ武器は、研究室に転がっていたGTX 580 2枚だけでした。
ここで歴史的な「欠乏」が発生します。GTX 580のビデオメモリ(VRAM)はわずか3GBでした。6,000万個のパラメータと65万個のニューロンを持つ巨大なニューラルネットワークを格納するには、到底足りない容量でした。
普通の人なら「機材が悪くてできない」と諦めてしまう状況です。しかし、彼らはこの制約条件を工学的な天才性で昇華させます。
「脳を二つに割ろう」
彼らはニューラルネットワークを半分に切り、2つのGPUに分けて格納しました。
これが、**グループ畳み込み(Grouped Convolutions)**と**モデル並列化(Model Parallelism)**の始まりとなります。
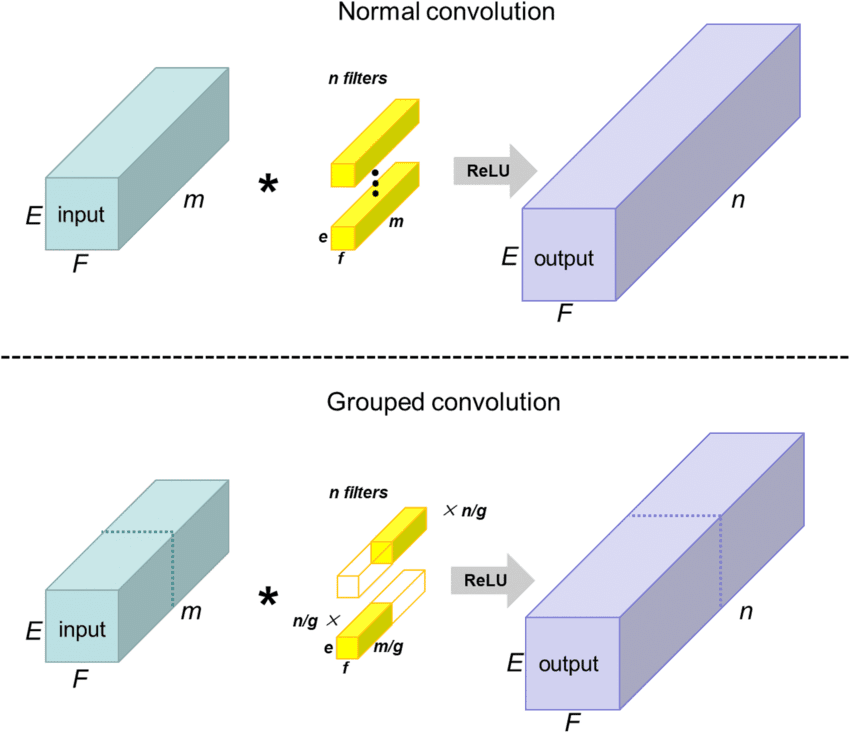
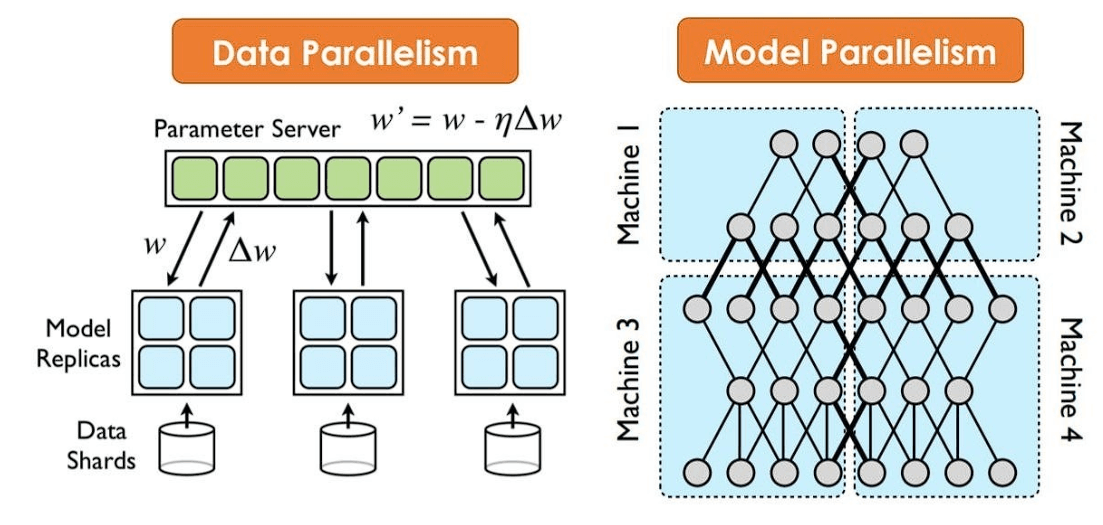
並列処理の最大化: 2つのGPUはそれぞれ計算を進め、情報交換が不可欠な層(Layer)でのみデータをやり取りしました。通信のボトルネックを最小限に抑えたのです。 高速化されたフィードバック: CPUで数ヶ月かかる学習を6日間に短縮し、実験と失敗を猛烈な勢いで繰り返すことが可能になりました。 ReLUの導入: 複雑な関数ではなく、$f(x)=max(0,x)$というシンプルで無骨に見えるReLU関数を導入し、学習速度を6倍加速させました。
皮肉なことに、*‘メモリ不足’というハードウェアの限界を克服しようとした**「裏技」が、現代AIアーキテクチャの標準を作り上げてしまった**のです。

4. ジェンセン・フアンの賭け:「会社を賭けたベット (Bet the Company)」
AlexNetの成功を見たNVIDIAのCEO、ジェンセン・フアンは戦慄しました。
彼は本能的に悟りました。
「これからのソフトウェアは、人間がコーディングするのではなく、データがコーディングするようになるだろう。」
2013年、彼はNVIDIAの全リソースをAIに注ぎ込む決断を下します。
社内ではこれを**「会社を賭けたベット(Bet the Company)」**と呼んでいました。
当時、好調だったゲーム収益を、不確実なAIというブラックホールに注ぎ込むのは、狂気じみた賭けに見えました。
しかし、彼は揺るがず、3つの変化を主導しました。
ハードウェアの再定義: GPUアーキテクチャをグラフィックレンダリング(描画)中心から**行列演算(計算)**中心へと完全に作り替えました。 エコシステムの構築 (Moat): 研究者がハードウェアを知らなくてもディープラーニングができるように、cuDNNというライブラリを配布しました。これは**TensorFlowやPyTorchがNVIDIAの上でしか動作しないようにする強力な堀(Moat)**となりました。 システム企業への進化: 2016年、世界初のAIスーパーコンピューターDGX-1を開発し、OpenAIに直接届けました。単なる部品メーカーではなく*「AIインフラ企業」*になるという宣言でした。
5. 共進化(Co-evolution):ソフトウェアがハードウェアを形作る
AlexNet以降の10年間は、ソフトウェアとハードウェアの完璧な二人舞(Pas de deux)でした。
これを**「ソフトウェア定義ハードウェア(Software-Defined Hardware)」**と呼びます。
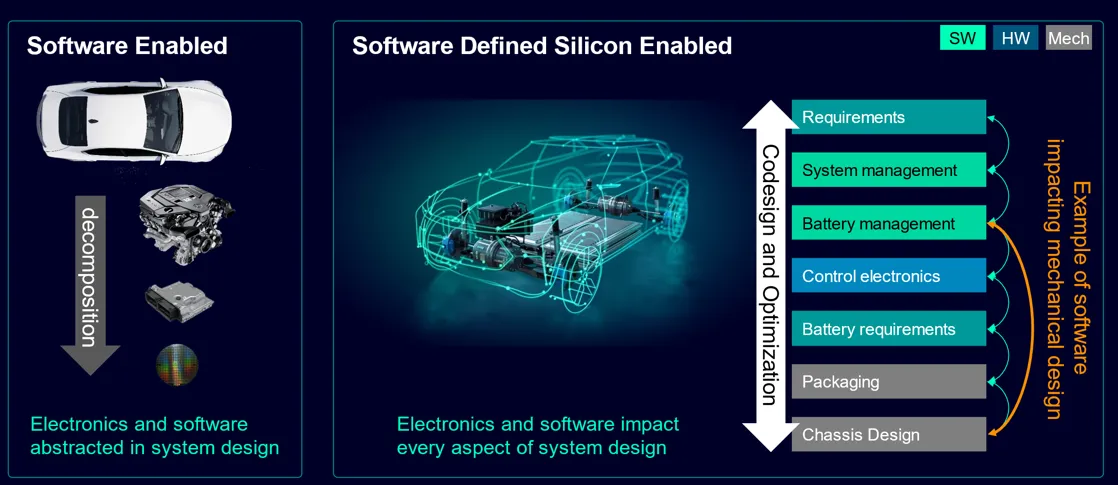
AIモデルが進化すると、チップもそれに合わせて進化しました。
Pascal (2016): AlexNetの時に経験した通信ボトルネックを解消するため、NVLinkという超高速道路を開通させました。 now GPU 8枚がまるで一つの巨大なチップのように動作します。 Volta (2017): ディープラーニングの核心である行列乗算だけを猛烈に処理する*「テンソルコア(Tensor Core)」*をチップに搭載しました。 Hopper (2022) & Blackwell (2024): TransformerとLLMのために、8ビット(FP8)、4ビット(FP4)演算までサポートし、メモリ帯域幅を極限まで拡大しました。
12年前、3GBメモリに苦しんでいたその技術は、今や数兆個のパラメータを飲み込む192GB HBM3eメモリを搭載した怪物(B200)へと進化しました。
6. ゲーマーのおもちゃから「知能工場(AI Factory)」へ
こうした技術的進歩は、経済地図を根底から変えました。
2012年、時価総額8兆ウォンに過ぎなかったNVIDIAは、2025年、**4兆ドル(約5,500兆ウォン)**の企業となりました。
さらに驚くべきは、売上構造の変化です。
かつてNVIDIAの資金源はPC방(インターネットカフェ)とゲーマーでした。
しかし、今や売上の80%以上がデータセンターから来ています。
Amazon、Google、MicrosoftがNVIDIAのGPUを買い求めて列をなしています。
ジェンセン・フアンの言葉を借りれば、データセンターはもはやデータを保存する倉庫ではなく、
**データを燃やして「知能(Intelligence)」という新たな財を生み出す「AIファクトリー」**となったのです。
この過程で、SK HynixやSamsung ElectronicsもHBM(高帯域幅メモリ)という高性能燃料を供給し、この巨大なエコシステムの必須パートナーとしての地位を確立しました。
7. Next Wave:死んでいた物理エンジンが復活し、「物理的AI」へ
今、NVIDIAは*AlexNetが開いた「認識」の時代、ChatGPTが開いた「生成」の時代を超え、新たな戦線を準備中*です。
それは、「物理的AI(Physical AI)」とロボティクスです。
ここで非常に興味深い技術の再利用が起こっています。
昔のゲームがお好きだった方は、「PhysX」を覚えていますか?
2008年にNVIDIAが買収した、ゲームの中で壁が壊れたりマントがなびいたりする物理エンジンです。
しばらくの間は、「グラフィックを綺麗にする」付加機能扱いされていました。
しかし、AI時代が到来すると、この技術が華麗に復活しました。
ロボットを現実で学習させると、転んだり壊れたりするばかりです。*そのため、仮想空間(Sim-to-Real)で学習させる必要がありますが、その際に重力、摩擦、衝突を完璧に計算してくれるシミュレーターが必要になったのです*。
NVIDIAのロボティクスプラットフォーム「Isaac」は、昔のゲーム用物理エンジン技術を基盤に、数千万台のロボットを仮想世界で同時に訓練します。
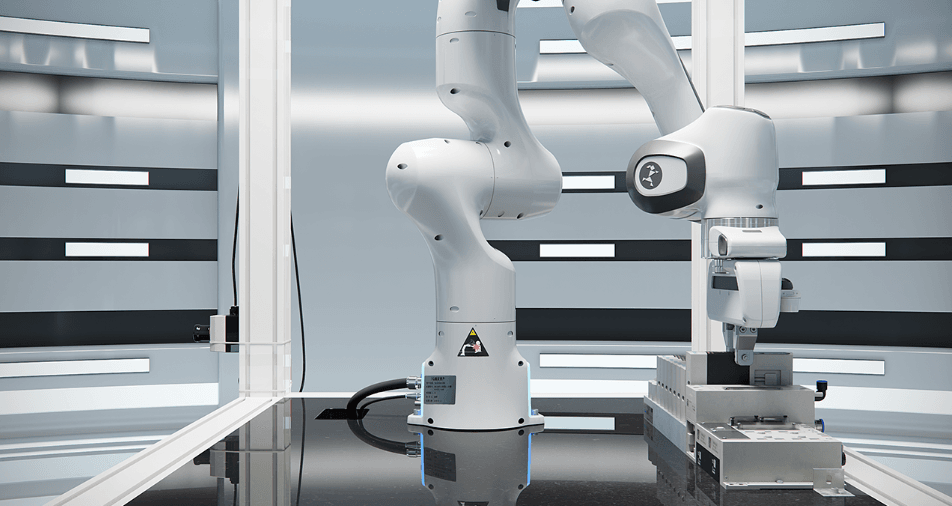
20年前のゲーマーを楽しませていた技術が、今やヒューマノイドロボットの小脳(Cerebellum)を作るためのコアインフラとなったのです。
8. エピローグ:認識を超えて行動する知性へ
整理しましょう。
2012年 AlexNet: コンピューターに**「目(Vision)」**を与えました。 2022年 ChatGPT: コンピューターに**「口(Language)」**を与えました。 Next NVIDIA: 今、コンピューターに**「体(Body)」**を与えようとしています。
学習(Training)から推論(Inference)へ、仮想の知能から物理的な知能へと進むこの旅の中心には、常にハードウェアとソフトウェアの熾烈な共生がありました。
もしあの時、GTX 580のメモリが十分にあったらどうだったでしょうか?
もしかしたら、「並列処理」という革新的なアイデアは生まれなかったかもしれません。
イノベーションは豊かさの中から生まれることもありますが、時には**「欠乏を克服しようとする切迫した試み」**の中から最も輝かしい姿で誕生します。
私たちは今、その欠乏が生み出した4兆ドル級の花火の真っただ中にいます。
次の火花はどこから飛び散るのでしょうか?それは、また別の誰かの「欠乏」の中に隠れているのかもしれません。
参考資料
- ImageNet Classification with Deep Convolutional Neural Networks \[AlexNet Paper\]
2. NVIDIA: The Complete History and Strategy
\[Acquired Podcast\]3. Jensen Huang on the future of physical AI and robotics
\[The Economist\]4. The Intelligent Industrial Revolution: How AI Transforms Manufacturing
\[NVIDIA Blog\]