
最先端技術の象徴であるChatGPT、その始まりがモナコの στο casino であったと信じられますか?巨大言語モデル(LLM)の壮大な変遷を辿ります。
- 人工知能の源流となった確率的アイデア、モンテカルロ方法の原理
- AIの暗黒期とその克服、多層パーセプトロン、そしてディープラーニングのビッグバン
- 現代の 巨大言語モデル を可能にしたトランスフォーマーアーキテクチャの革新
- ChatGPTを超え、エージェントAIへと向かう技術の未来と国内の現状
人工知能の夜明け:確率とニューラルネットワークの登場
2022年の冬、世界はまるで魔法のように登場した人工知能チャットボット、ChatGPT に熱狂しました。一夜にして現れたかのようなこの驚くべき技術は、私たちの質問に淀みなく答え、詩を書き、コードを生成し、世界を震撼させました。まるでSF映画の中の未来が突然現実になったかのようでした。
しかし、これらすべてが本当に一夜にして成し遂げられた奇跡だったのでしょうか?それとも、私たちがまだ知らない数十年にわたる粘り強い旅の末に得られた成果だったのでしょうか?この問いに答えるために、私たちは時間を遡らなければなりません。驚くべきことに、その旅の始まりは最先端のコンピュータ研究所ではなく、偶然と確率が支配するモナコの στο casino でインスピレーションを得たアイデアから出発します。
1. カジノの秘密:不確実性を制したモンテカルロアルゴリズム
人工知能の歴史を語るのに、なぜカジノなのでしょうか?すべての始まりには、「モンテカルロアルゴリズム」というユニークな名前の方法論があります。この名前はモナコの有名なギャンブル都市、モンテカルロに由来しており、その原理もまたギャンブルの確率ゲームと深い関わりがあります。
モンテカルロ方法の核心は 「ランダムに何度も試すこと」 です。
数学的に完全に計算するのが非常に複雑であったり、不可能な問題に直面したとき、無数のランダムな試行を通じてその解に近い近似値を得る手法です。
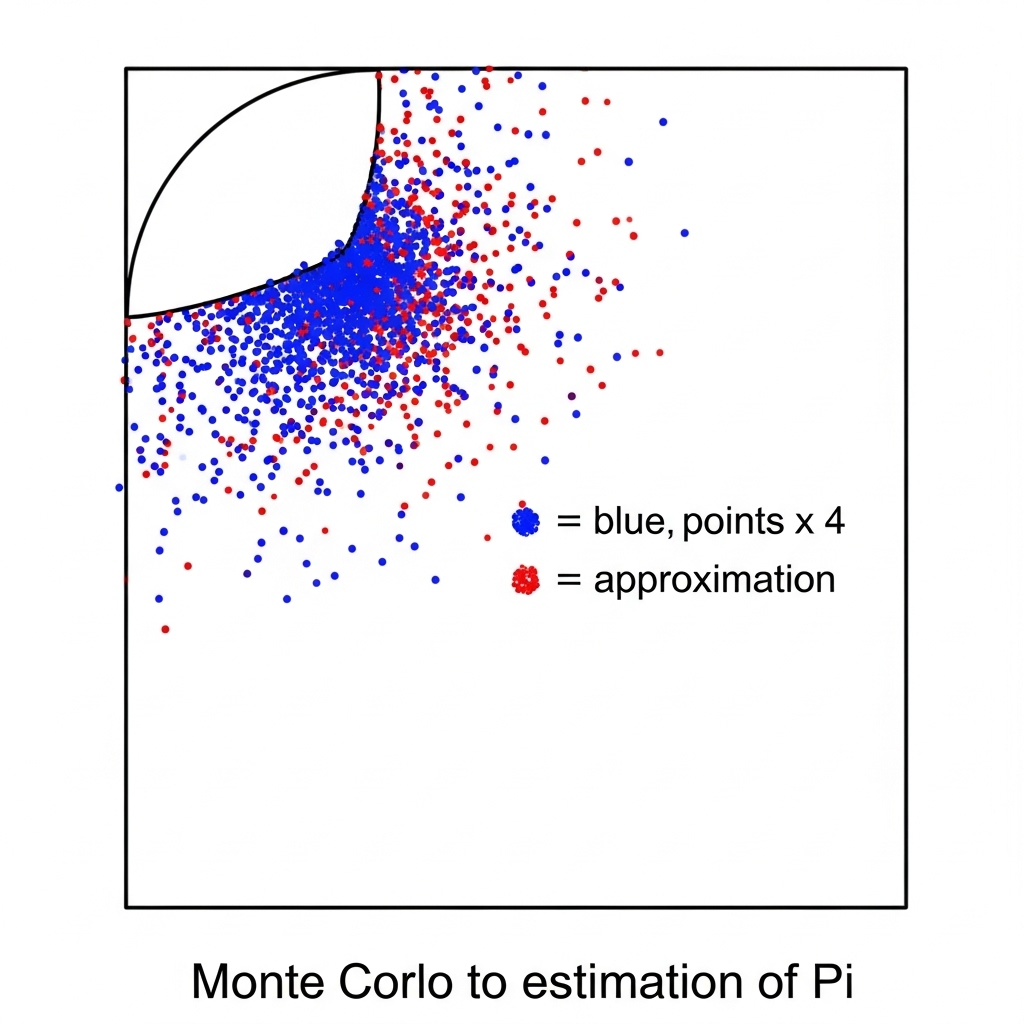
正方形の中にぴったり収まる円を描き、ランダムに点を打つと、点の数のおおよその割合から円周率の近似値を計算できます。
このアイデアは、チェスや囲碁のように、可能な組み合わせが無限に近いゲームにおいて、すべての組み合わせを計算する代わりに、有望な経路をいくつかランダムに探索して最適な手を見積もる方法として活用されました。後にイ・セドル九段を破った「AlphaGo」も、このアイデアを受け継いだ「モンテカルロ木探索(MCTS)」を主要な武器として使用しました。確率に基づいて最も可能性のある答えを見つけ出すこのアプローチは、後に次の単語を確率的に予測する 巨大言語モデル の基本哲学とも通じるものがあります。
2. 人工知能の誕生と二つの道
1956年のダートマス会議で 「人工知能(Artificial Intelligence)」 という言葉が初めて登場し、AI研究は大きく二つの方向へと分かれました。
- 記号主義(Symbolism): 人間の知能を論理的な規則と記号操作の結果とみなし、それをプログラミングしようとするトップダウンアプローチです。
- コネクショニズム(Connectionism): 脳の構造からインスピレーションを得て、数多くの人工ニューロンを接続すれば知能が創発すると信じるボトムアップアプローチです。
コネクショニズムの陣営で、1958年に心理学者のフランク・ローゼンブラットが開発した 「パーセプトロン(Perceptron)」 は、脳のニューロンを模倣した最初の実用的な人工ニューラルネットワークモデルでした。複数の入力を受け取り、重みを掛け合わせ、その合計がある閾値を超えると活性化されるというシンプルな構造でした。革新的な点は、この重みをデータから「学習」できることでした。
3. 最初の冬:AIを挫折させたXOR問題
パーセプトロンは、ANDやORのように、一つの直線で正解と不正解を分けられる「線形分離」問題をうまく解決し、AI研究界に楽観論をもたらしました。
しかし、この楽観論は「XOR(排他的論理和)」という非常に簡単な問題の前で崩れ去りました。XORは、二つの入力値が互いに「異なる」場合にのみ真となるのですが、この結果はどのような直線でも分けることができません。
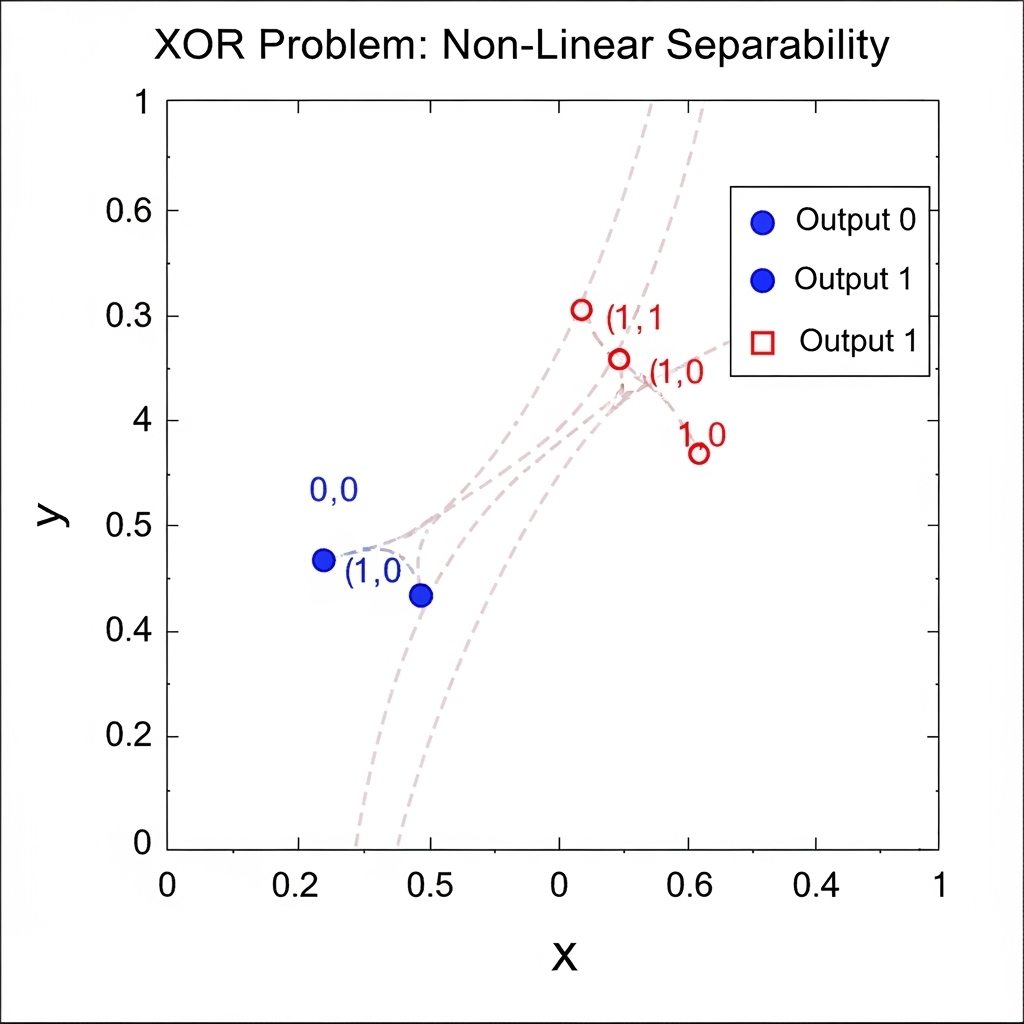
1969年にマービン・ミンスキーがこの限界を数学的に証明すると、AIへの期待は失望に変わり、投資が急減する 「AIの冬(AI Winter)」 が訪れました。個人的には、XOR問題の衝撃は、すべての材料とレシピを持っているのに、決定的な調味料が一つ足りずに料理を台無しにしてしまったようなものだったと思います。この簡単な問題がAI全体への期待を打ち砕き、長い停滞期をもたらしたという事実は、革新が常に大きな難関ではなく、小さなディテールにつまずくことがあるという教訓を与えてくれます。
ディープラーニングの飛躍と巨大言語モデルの序章
過酷な冬を越え、AIはより深く複雑な構造へと進化し、再び飛躍の機会を迎えます。
4. 暗黒期を終わらせた救世主:多層パーセプトロンとバックプロパゲーション
最初のAIの冬を終わらせたのは、「一つの線でダメなら、複数の線を使おう」というアイデアを実装した 「多層パーセプトロン(Multi-Layer Perceptron, MLP)」 でした。MLPは、入力層と出力層の間に一つ以上の「隠れ層(hidden layer)」を追加した構造です。隠れ層はデータを非線形に変換し、単層パーセプトロンが解けなかったXORのような問題を解決することを可能にしました。
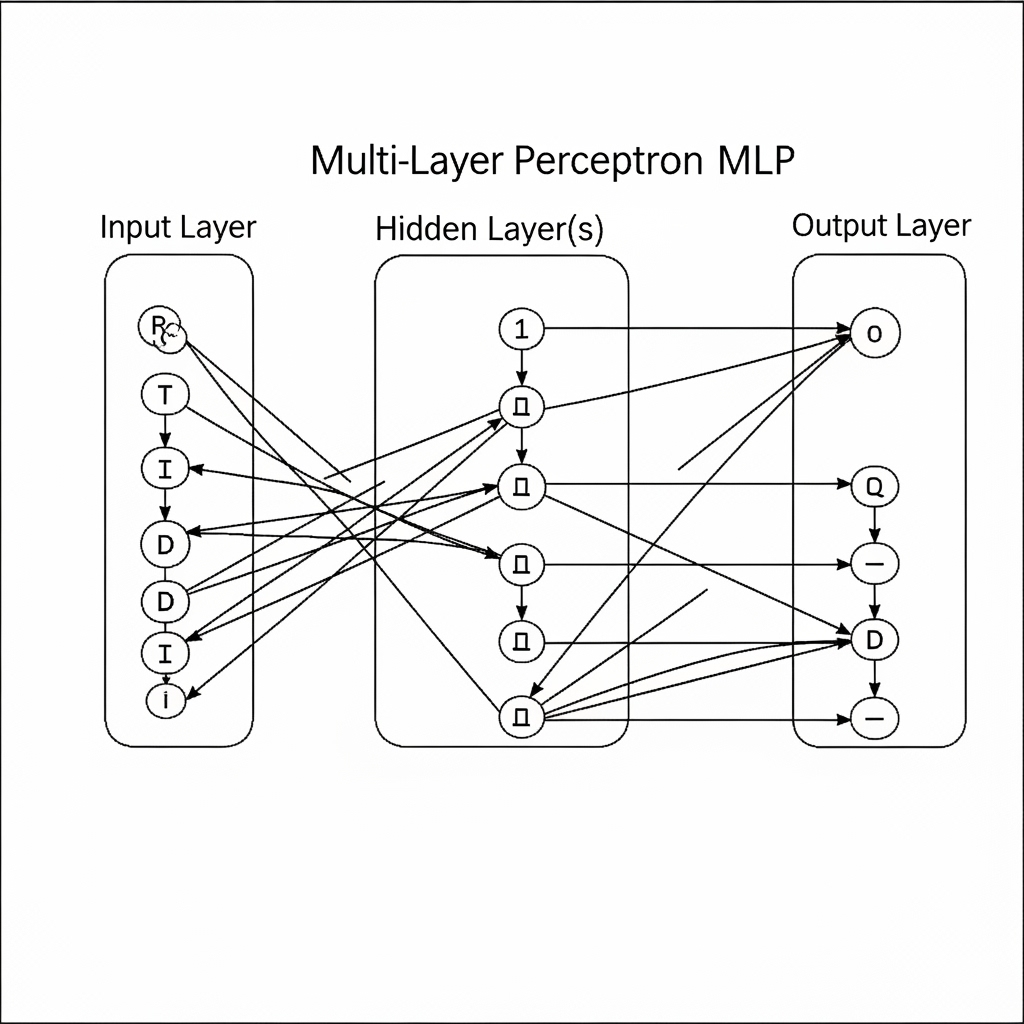
しかし、この複雑なネットワークを学習させることが問題でした。この難題を解決したのが 「誤差逆伝播(Backpropagation)」 アルゴリズムです。逆伝播は、最終結果の誤差を逆に伝播させ、各接続(重み)が誤差にどれだけ寄与したかを計算して修正していく方式で、深いニューラルネットワークを学習させる強力な武器となりました。
5. 2012年、ディープラーニングのビッグバン:AlexNetの登場
1980年代に理論的な武器は整えられましたが、ディープラーニングがその潜在能力を爆発させるまでには、「ビッグデータ」 と 「GPU」 がさらに必要でした。2009年に公開された1,400万枚の画像データセット 「ImageNet」 と、GPUの強力な並列計算能力が組み合わさることで、ついに三位一体が完成しました。
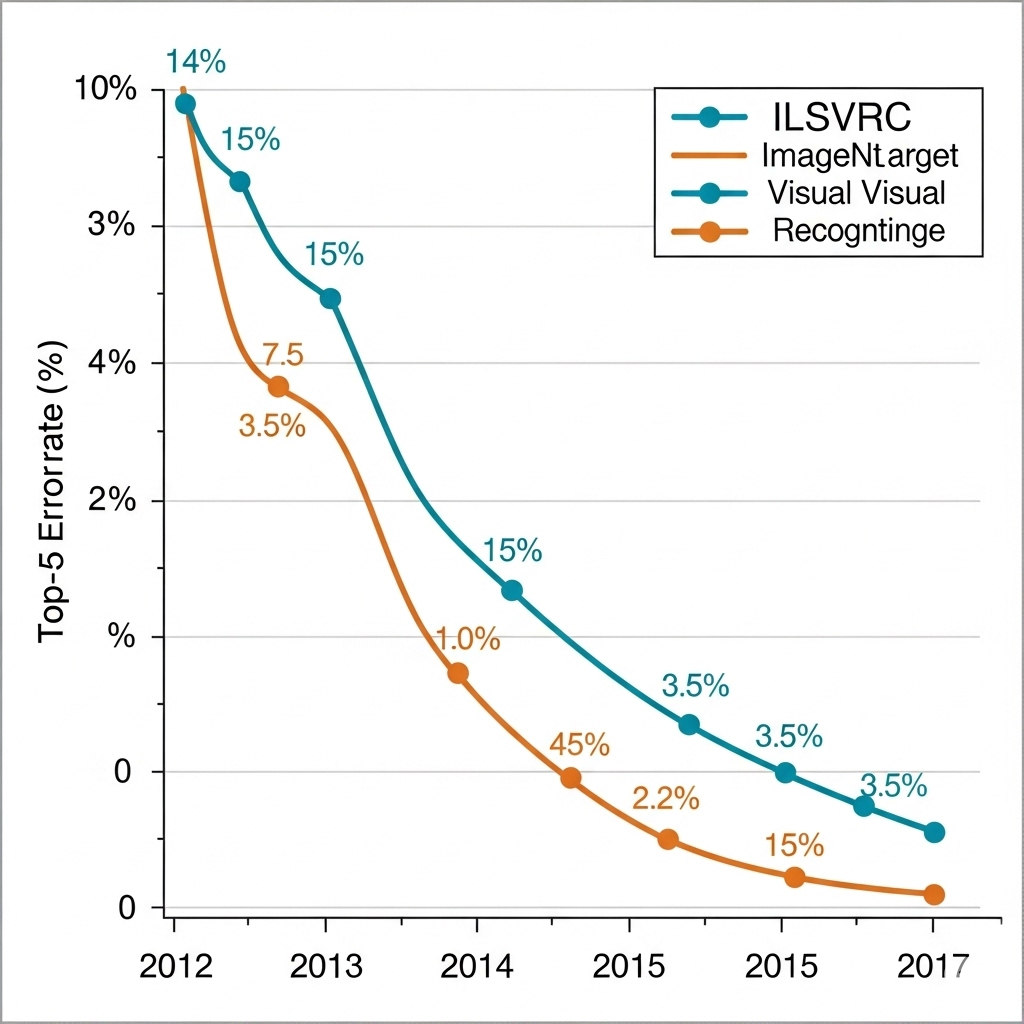
2012年、ジェフリー・ヒントン教授チームの深層畳み込みニューラルネットワーク(CNN) 「AlexNet」 は、ImageNetチャレンジで15.3%という圧倒的な誤り率で優勝し、ディープラーニング時代の幕開けを告げました。この出来事は、「規模が 곧 성능(性能)」という信念を広め、後に 巨大言語モデル の登場を予感させました。
6. 時間の流れを理解する:リカレントニューラルネットワーク(RNN)
画像の征服後、AIの次の目標は、言語のように「順序」が重要な 「シーケンシャルデータ(Sequential Data)」 でした。そのために登場したモデルが 「リカレントニューラルネットワーク(Recurrent Neural Network, RNN)」 です。RNNは、ネットワーク内部に「循環」するループを作り、前の段階の情報を記憶して現在の計算に反映させました。
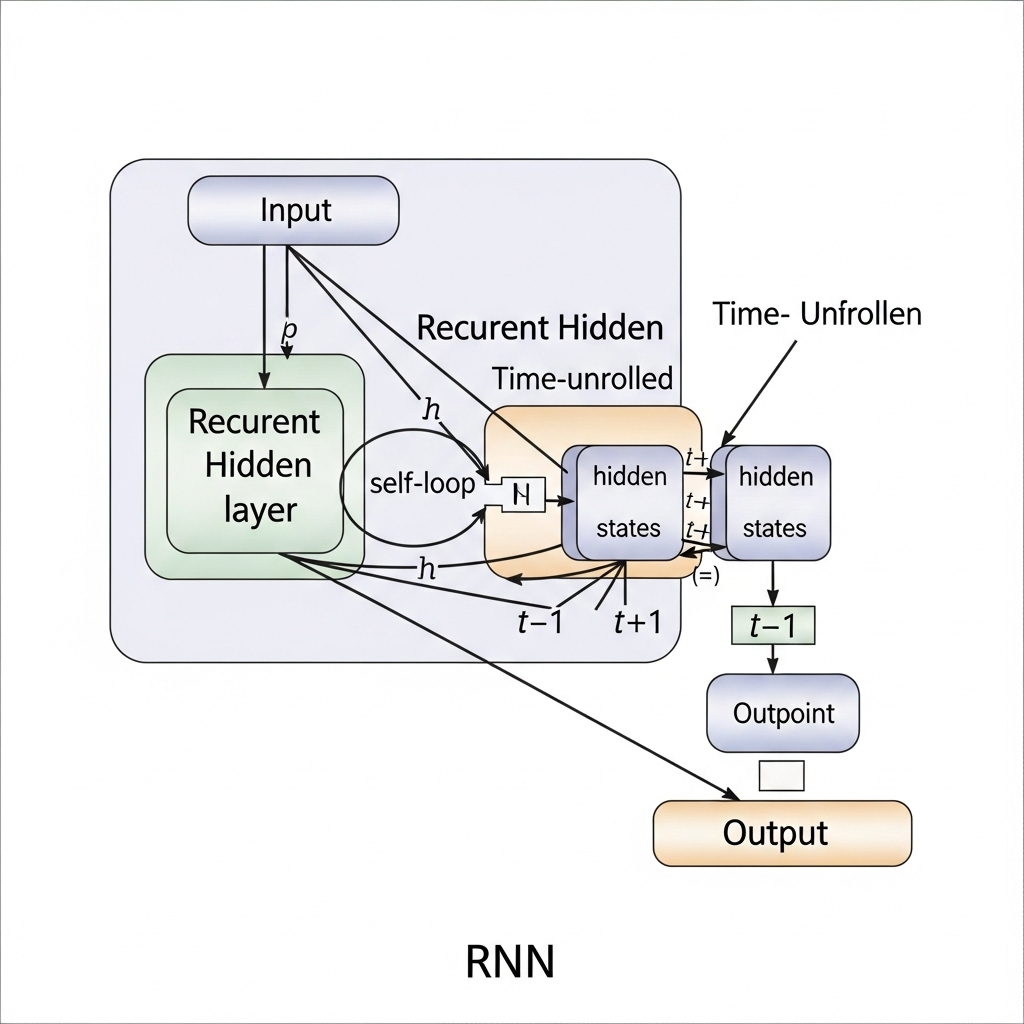
しかし、RNNは文章が長くなるにつれて、前半の情報を忘れてしまう 「長期依存性問題」 という致命的な弱点がありました。LSTM や GRU のような改善モデルが登場しましたが、順次処理しなければならないという根本的な限界は依然として残っていました。
現世の神、トランスフォーマーと巨大言語モデル
2017年、すべてを変える論文が一編登場し、真の 巨大言語モデル の時代が開かれます。
7. 「Attention Is All You Need」:世界を変えたトランスフォーマー
2017年にGoogleが発表した論文は、「トランスフォーマー(Transformer)」 という革新的なアーキテクチャを披露し、シーケンシャルデータ処理の根幹であった「循環」構造を完全に捨て去りました。
トランスフォーマーは 「セルフアテンション(Self-Attention)」 メカニズムを通じて、すべての単語を一度に展開し、各単語が文中の他のすべての単語と結びつく関係性の重要度を同時に計算します。
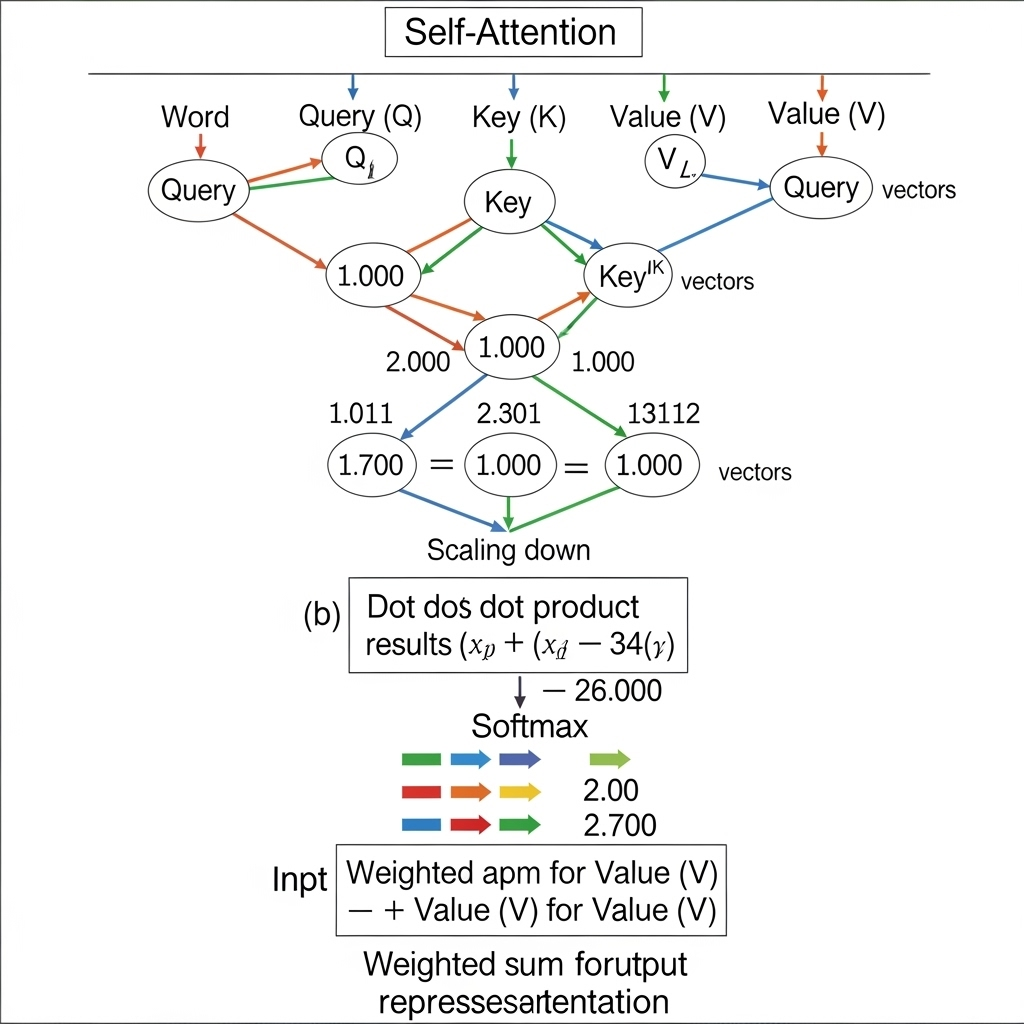
この方式は、長期依存性問題を根本的に解決しただけでなく、すべての計算を並列処理できるため、GPUの性能を極限まで活用することを可能にしました。この圧倒的な効率性は、以前は想像できなかった 「巨大(Large)」言語モデル の時代を開きました。
8. 巨人の時代:BERTとGPT
トランスフォーマーを基盤に、自然言語処理の世界を二分する二つの巨大モデル、BERTとGPTが誕生しました。この二つを簡単に例えるなら、BERTは探偵、GPTは物語作家です。
- BERT(文脈の探偵): 文中の空欄を埋めるために、前後両方の文脈をすべて考慮する 「マスク言語モデル」 方式で学習します。文章全体を双方向で考慮するため、単語の微妙な意味を捉える「理解」能力に優れており、Google検索エンジンの核心技術として活用されています。
- GPT(創造的な物語作家): 与えられた単語の次に最も確率の高い単語を予測する方式で学習します。この「自己回帰的」な方式のおかげで、新しいテキストを創造的に「生成」することに強力な力を発揮します。特にGPT-3は、いくつかの例だけで新しいタスクを実行する 「フューショット学習」 能力を示し、汎用AIの可能性を開きました。
9. 人間的なAIの誕生:ChatGPTの秘密、RLHF
GPT-3は驚異的でしたが、時には嘘をついたり、有害な内容を生成したりすることもありました。モデルを人間の意図や価値観に「整合(Alignment)」させるプロセスが必要でした。
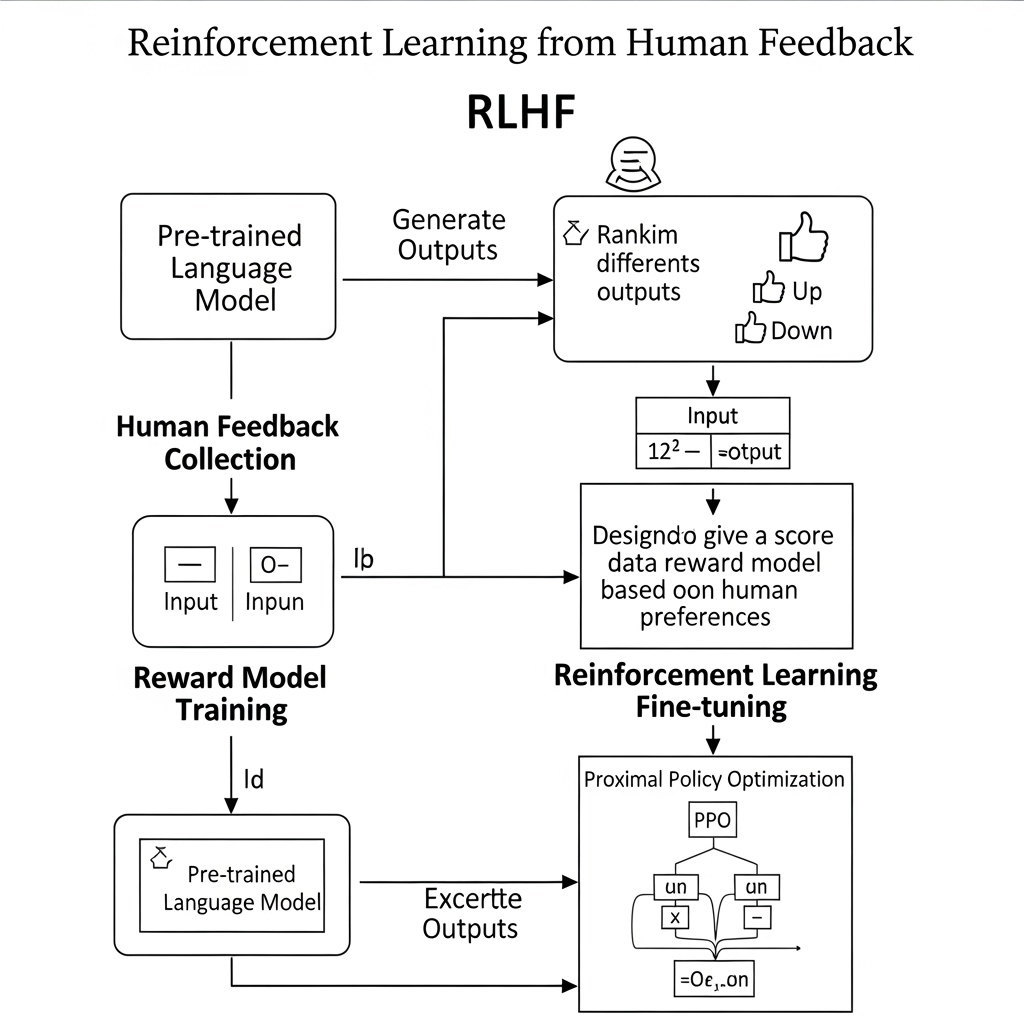
この問題を解決し、ChatGPTを誕生させた核心技術が 「人間のフィードバックからの強化学習(RLHF)」 です。
- 第1段階(指示チューニング): 「指示-模範回答」のデータセットで、モデルにユーザーの指示に従う基本的な能力を教えます。
- 第2段階(報酬モデルの訓練): 人間が複数の回答の好ましさの順位付けをすると、それを学習してどの回答がより良いかを点数付けする「審判AI」を作成します。
- 第3段階(強化学習): 第1段階のモデルが回答を生成すると、第2段階の審判AIが採点し、モデルはより高い点数を得る方向へ自身を修正していきます。
最近では、このプロセスを単純化した 「直接選好最適化(DPO)」 のような、より効率的な技術も注目されています。
韓国の巨大言語モデルの現状と未来
ChatGPTが引き起こしたLLM戦争の中、韓国の言語と文化を深く理解する「主権AI」を確保するため、国内企業も熾烈な競争を繰り広げています。
韓国LLM代表選手比較
| 開発会社 | モデル名 | 主な特徴 |
| — | — | — |
| Naver | HyperCLOVA X | 広範なNaverデータ基盤、韓国語特化、「Thinking」機能、自社サービス(検索、ショッピングなど)連携 |
| Kakao | Koala (旧KoGPT) | オープンソース(商用利用可能)、軽量化と効率性、韓国語性能優秀、マルチモーダル対応 |
| SKT | A.X (エイドットエックス) | 「From Scratch」独自開発、マルチモーダル(VLM)、高性能文書エンコーダー、通信特化 |
| LG AI Research | EXAONE | 専門家用AI、推論+生成ハイブリッド、数学・コーディング・科学など専門分野特化 |
| Upstage | SOLAR | 軽量モデル(SLM)で最高レベルの性能、高い効率性と費用対効果、グローバルリーダーボード1位 |
このように熾烈化する競争の中で、Upstageが主導する 「Open Ko-LLM Leaderboard」 は、国内モデルの性能を客観的に比較する標準ベンチマークの役割を果たし、国内AIエコシステムの発展に貢献しています。
結論:エージェントAIへの旅と私たちの課題
サイコロを振ることから始まったAIの旅は、70余年ぶりに人間のように会話する 巨大言語モデル の時代を開きました。今、技術は次の段階である 「エージェントAI(Agentic AI)」 へと進んでいます。エージェントAIは、自ら目標を設定し、計画を立て、ツールを使って複雑なタスクを自律的に実行する能動的な問題解決者です。
この目覚ましい未来を前に、ジェフリー・ヒントンは超知能の危険性を警告し、ヤン・ルカンは現在のLLMの「常識」不足を指摘し、新しいアーキテクチャの必要性を主張しています。彼らの議論は、私たちが技術の頂点ではなく、新たな出発点に立っていることを示しています。
主要な要約
- 確率から始まった旅: AIは、完璧な計算ではなく、カジノの確率ゲームからインスピレーションを得た「最も可能性のある答え」を見つける確率的アプローチから始まりました。
- トランスフォーマーの革命: シーケンシャル処理の限界を克服したトランスフォーマーアーキテクチャは、並列処理と文脈理解能力を最大化し、巨大言語モデル(LLM)時代を開きました。
- 人間との整合、そして未来: ChatGPTはRLHFを通じて人間の意図に合わせられ、今やAIは自ら計画し実行する「エージェントAI」へと進化しようとしています。
この強力な新技術をどのように開発し、責任を持って社会に統合していくかを決定する次の章は、まさに私たち全員の手に委ねられています。この驚くべき技術の発展が私たちにどのような意味を持つのか、今日紹介された国内LLMの一つを実際に使ってみて、その可能性と限界を感じてみるのはいかがでしょうか?
参考資料
- モンテカルロ法 - Namu Wiki リンク
- ダートマス会議 - Wikipedia リンク
- AIの冬 - Wikipedia リンク
- 誤差逆伝播とは? - IBM リンク
- ImageNet - Wikipedia リンク
- リカレントニューラルネットワーク(RNN)とは? - AWS リンク
- [1706.03762] Attention Is All You Need - arXiv リンク
- The Illustrated Transformer - Jay Alammar リンク
- Illustrating Reinforcement Learning from Human Feedback (RLHF) - Hugging Face リンク
- 韓国LLMモデルの現状と比較 - MSAP.ai リンク
参考文献
- モンテカルロ法 - Namu Wiki
- ダートマス会議 - Wikipedia
- AIの冬 - Wikipedia
- 誤差逆伝播とは? - IBM
- ImageNet - Wikipedia
- リカレントニューラルネットワーク(RNN)とは? - AWS
- [1706.03762] Attention Is All You Need - arXiv
- The Illustrated Transformer - Jay Alammar
- Illustrating Reinforcement Learning from Human Feedback (RLHF) - Hugging Face
- 韓国LLMモデルの現状と比較 - MSAP.ai