
2025年7月1日。 歴史書はこの日を「インターネットの扉が閉ざされた日」と記録するかもしれません。
率直に話しましょう。
私たちは過去30年近く、インターネットという空間を、まるで空気や水のように、当然与えられる無料の公共財だと考えてきました。
検索窓に単語を入力すれば0.1秒で情報が溢れ出し、ブログに記事を書けば誰かが読みに来てくれる平和な世界でした。しかし断言します、その**「無料インターネット」の時代は終わりました。**
死因は明確です。
それは「信頼の完全な崩壊」です。
過去のウェブは、**“あなたが良い情報を上げれば、私たちはトラフィック(人)を送ってあげる”**という、暗黙の物々交換契約で維持されていました。
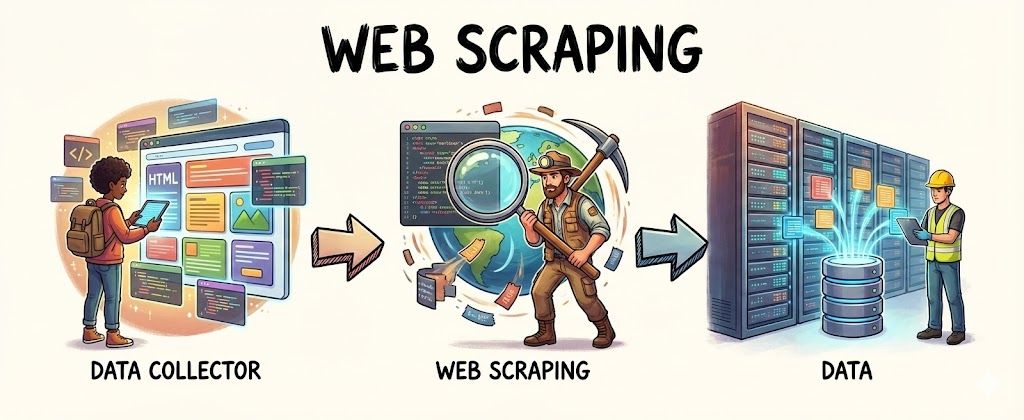
しかし、ChatGPTやGeminiのような生成AIが登場したことで、この約束は紙くず同然になりました。
AIは情報を読み取るだけで、原作者に一人たりとも訪問者を返さない**「ゼロクリック(Zero-click)」**時代を開いたからです。
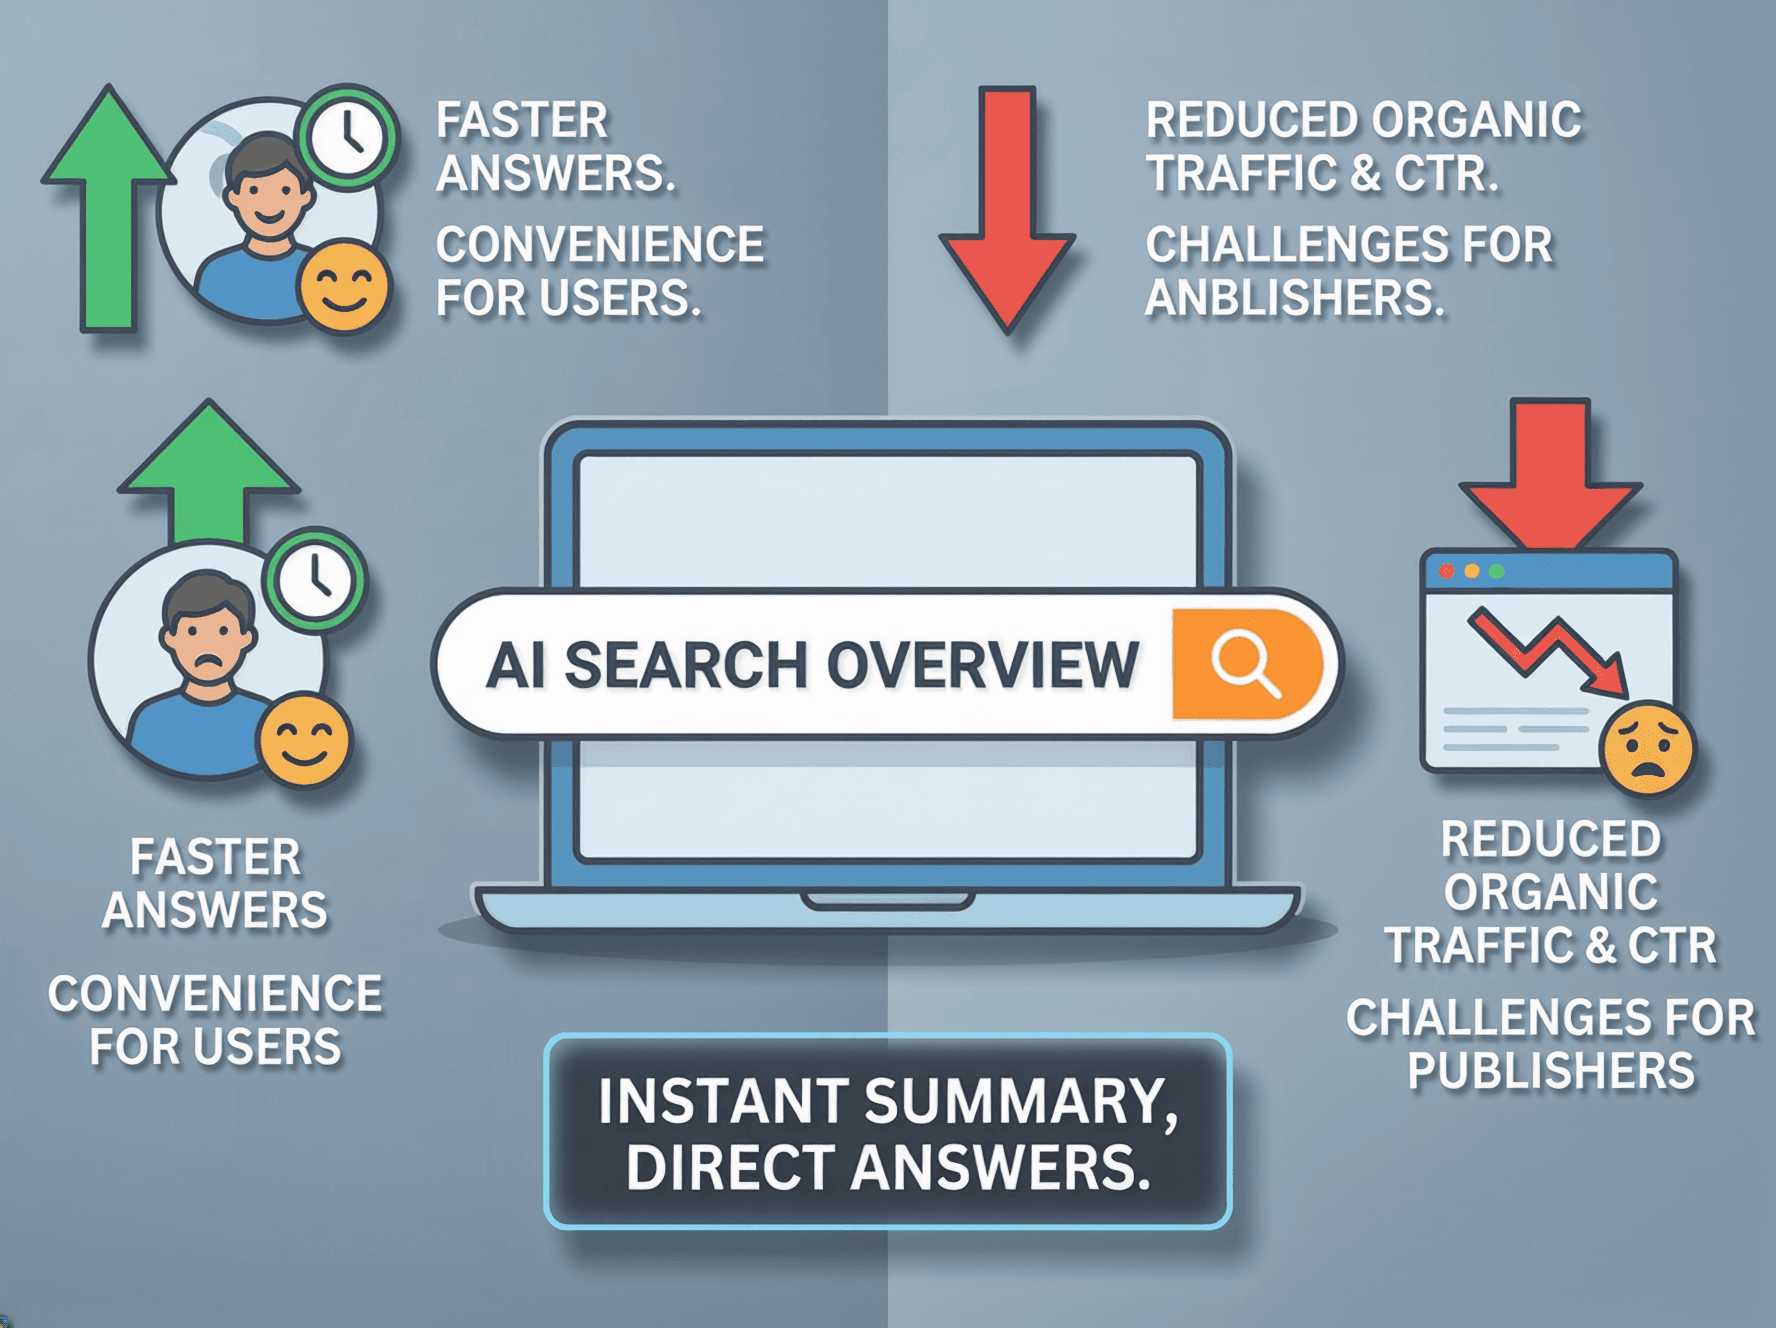
今や寄生虫が宿主を蝕むのを防ぐため、ウェブの守護者たちは巨大な城壁を築き始めました。
これからお話しする物語は、単なる技術トレンドではありません。
これは、あなたが何気なく残した一文、一枚の写真を取り巻いて繰り広げられる**「第一次デジタル資産戦争」**の生々しい記録です。
1. 見えない戦争:インフラが武器になる
今この瞬間も、ウェブの見えない裏側(Back-end)では、槍と盾の激しい戦いが繰り広げられています。
全世界のウェブトラフィックの門番である**Cloudflare**が、AIボットとの全面戦争を宣言したからです。
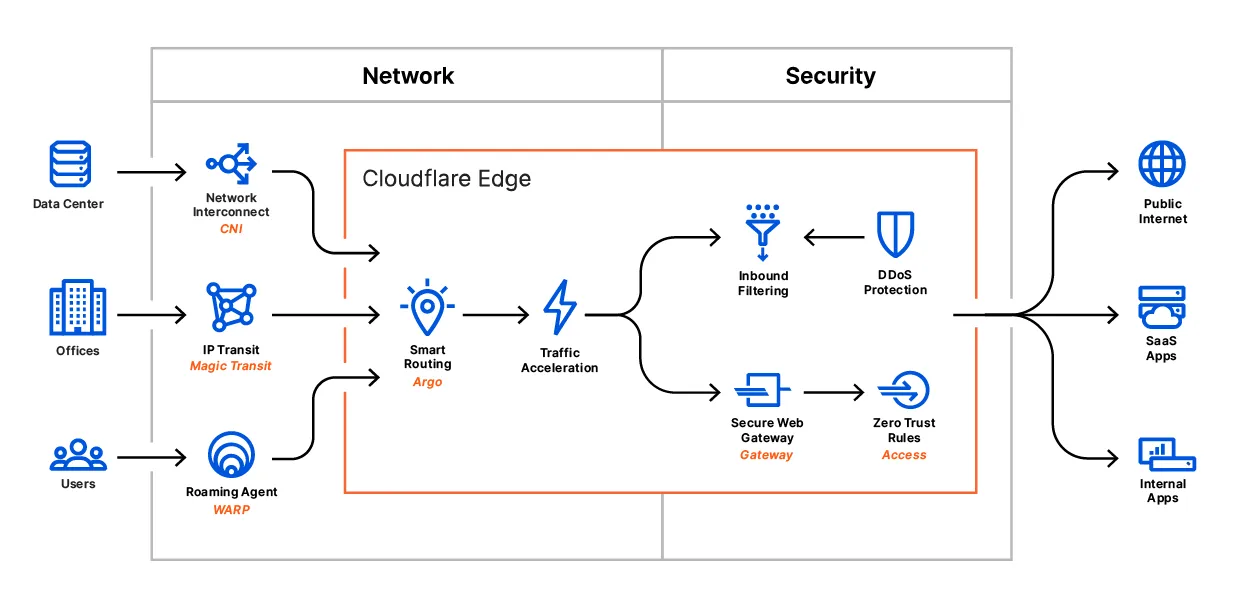
もはや「丁寧な依頼」は通用しない、荒々しい時代が到来しました。
1.1. ロボットの立ち入り禁止区域:紳士協定の破棄
インターネットの黎明期、ウェブの秩序はrobots.txtという非常にシンプルなテキストファイル一つに依存していました。
ウェブサイトの管理者が「ここから先は入らないでください」と書き置けば、検索ロボットたちはそれを礼儀正しく守っていました。
これがウェブエコシステムを支えていた**紳士協定(Gentlemen’s Agreement)**でした。
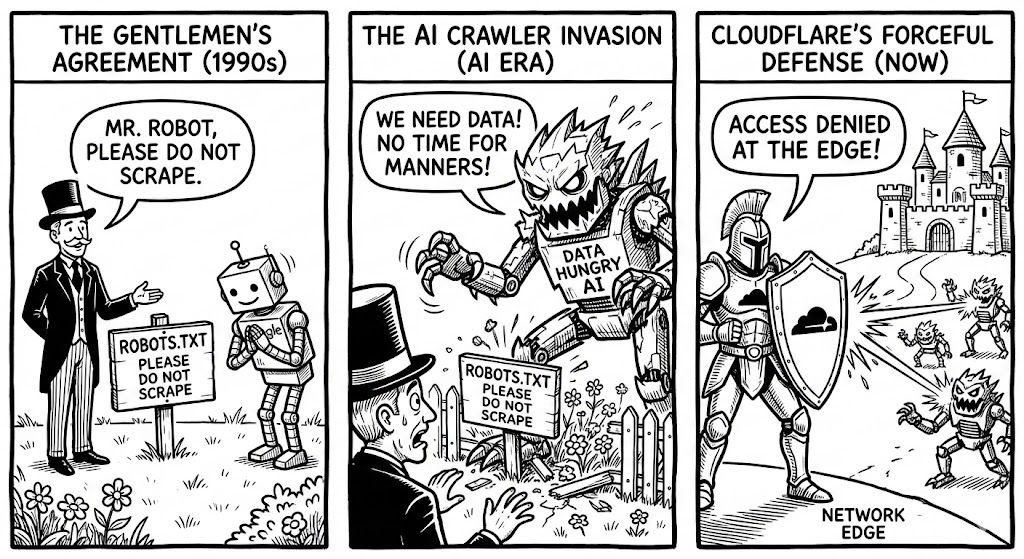
しかし、データに飢えたAI企業たちは、この古びた標識を無視して塀を乗り越え始めました。
学習データの確保が生死に直結したからです。
これに対しCloudflareは刀を抜きました。
もう、承認されていないAIボットが検知されたら? ウェブサイトサーバーに近づく前に、ネットワークの端(Edge)で即座に物理的に追放されます。
1.2. 死んでいたコードの復活:HTTP 402
最も衝撃的な変化は、技術的な遮断ではありません。それは「経済的障壁」の登場です。
皆さんは「404 Not Found」(ページが見つかりません)や「403 Forbidden」(アクセス禁止)には慣れているでしょう。
ところが、インターネットの歴史書の片隅に埋もれ、開発者の間でも伝説として語られていた「幽霊コード」が墓場から這い出てきました。
それが**HTTP 402 Payment Required(支払いが必要)**です。
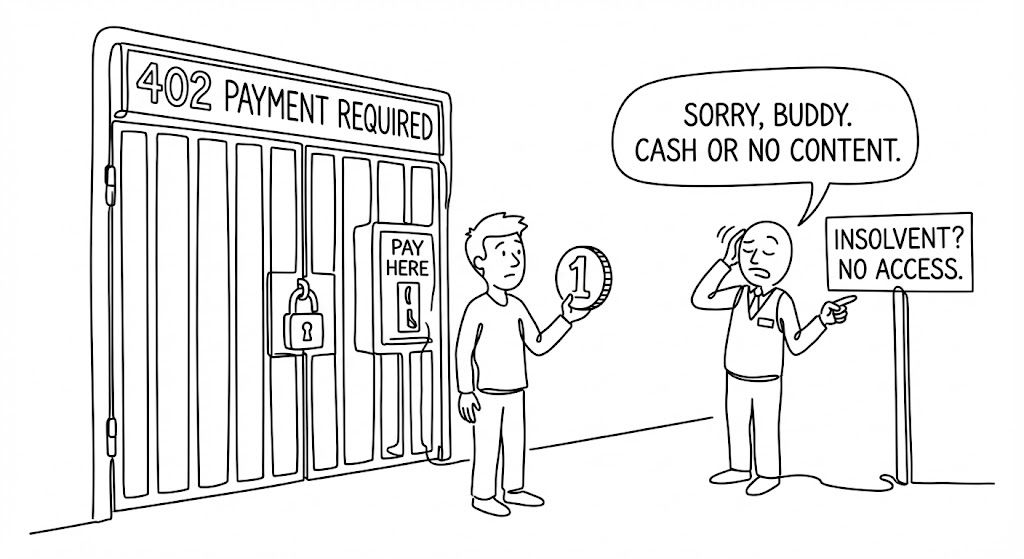
Cloudflareが提示した**「クロールごとの支払い(Pay Per Crawl)」**モデルは、冷酷なまでに資本主義的です。
- AIボットがデータを要求します。 2. システムはコンテンツの代わりに請求書を送信します。 「402 Payment Required: このデータを持っていくには0.05ドルを支払え。」 デジタル・トークンで費用を支払って初めて扉が開きます。
もはやAIにとってウェブは無料の図書館ではありません。入場料を払わなければ本を開けない、徹底した有料書店になったのです。
1.3. ボットを閉じ込める迷宮:AIラビリンス(AI Labyrinth)
では、お金を払わずにこっそり情報を盗もうとする「泥棒ボット」たちはどうなるのでしょうか?
防御システムは、彼らのために**「AIラビリンス(Labyrinth)」**を稼働させます。
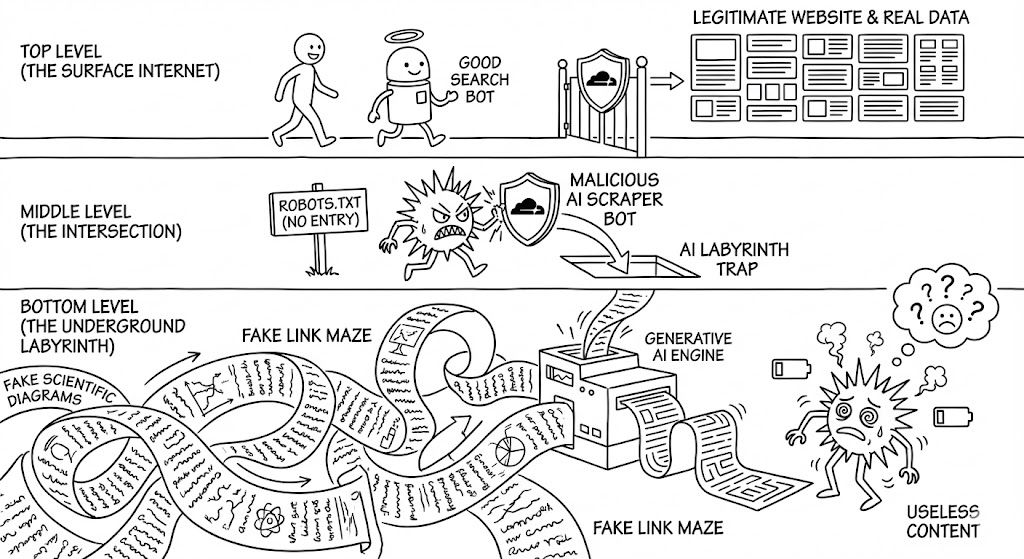
ボットに偽のリンクをそっと流すと、ボットはそれが本物の情報だと思い込んで食いつきます。
しかし、そこは地獄です。
AIがリアルタイムで生成した**「もっともらしくて意味のないテキストの塊」**が無限に続くからです。
業界ではこれを**「タールピット(Tar Pit、粘着質な沼)」**と呼んでいます。
ボットはこの沼にハマり、無意味なゴミデータを収集するために莫大なサーバー費用と電気代を浪費するだけになります。
2. 槍と盾:技術的軍拡競争
防御者が扉に鍵をかければ、泥棒は鍵開けの技術を学びます。
単純な遮断を超えた、高度に進化する技術的軍拡競争が始まりました。
2.1. デジタル指紋(Fingerprint)の対決:JA4
もはやIPアドレスを遮断するだけでは意味がありません。
ボットは1秒ごとにIPを変更し、数百万もの仮面を被るからです。
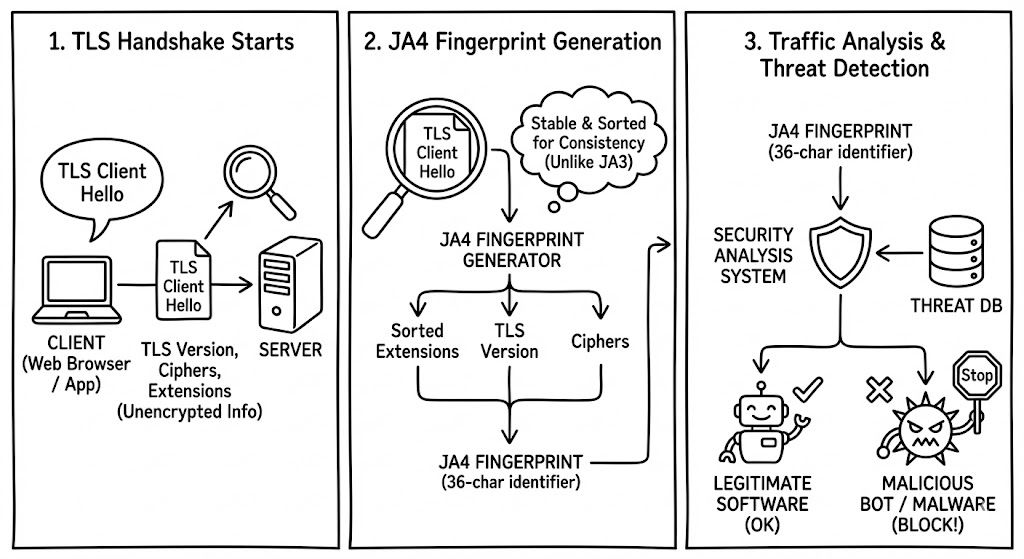
そこで防御者たちはJA4フィンガープリンティングという技術を使用します。
簡単に例えましょう。ある泥棒が毎回服を着替え、変装して侵入してきますが、
その人特有の**「歩き方」や「息遣い」**は変えられないとしましょう。
JA4は、まさにボットの通信習慣(TLSハンドシェイクパターン)を分析して指紋を取ります。
**「君は見た目はChromeブラウザだと主張するが、通信の歩幅を見るとPythonスクリプトに違いない!」**と見抜くのです。
2.2. ゾンビになった冷蔵庫とAI解決屋
攻撃者たちの反撃も侮れません。
最も恐ろしい点は、彼らが私たちの日常にある機器を利用していることです。
- 住宅用プロキシ(Residential Proxies): ボットはハッキングされた家庭用ルーター、スマート冷蔵庫、CCTVなどを経由して接続します。防御システムから見れば、普通の家庭から接続しているように見えるため、遮断が非常に困難です。あなたのスマート冷蔵庫が、今この瞬間、**AIのデータ窃盗を助ける「ゾンビ」になっているかもしれません。 * AIキャプチャソルバー(CAPTCHA Solver): 「ロボットではありません」にチェックを入れるパズルは、もはや無効です。最新のAIは人間よりもパズルをうまく解き、さらにはマウスカーソルを人間のようにふらつかせながら動かす「人間コスプレ」**まで完璧に学習しました。
2.3. ピクセル戦争:ナイトシェイド(Nightshade)
データ自体に毒を仕込む技術も登場しました。
シカゴ大学が開発した**「ナイトシェイド(Nightshade)」**は、画像に人間の目には絶対に見えない微細なノイズを混ぜ込みます。
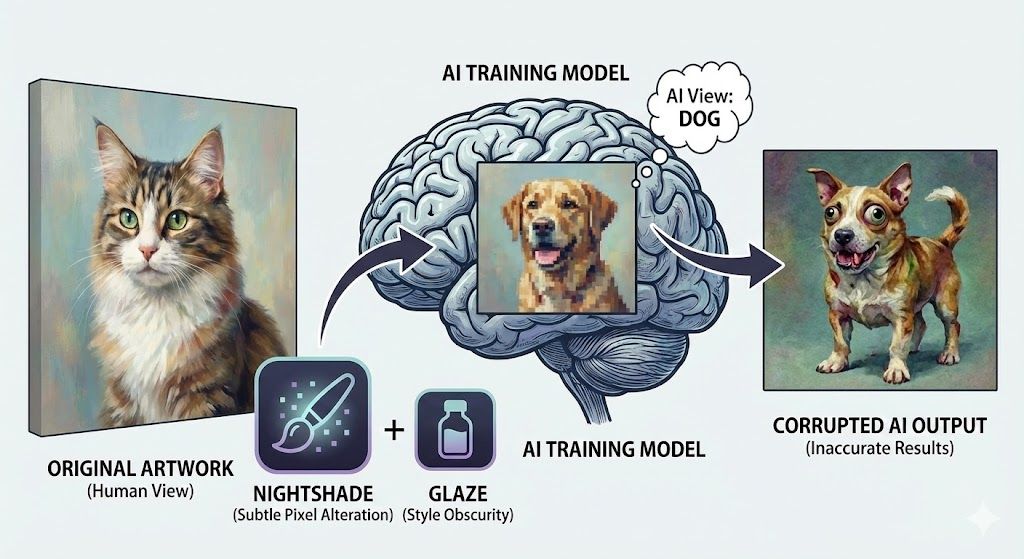
この絵をAIが学習すると、恐ろしいことが起こります。
AIは「猫」の絵を「犬」と認識し、「ハンドバッグ」を「トースター」と誤解するようになります。
*訓練データが汚染され、モデル全体が壊れる**「モデル中毒」**を引き起こすのです。*
アーティストたちが自分の作品を守るために、自らデータに「毒薬」を 뿌려야만 하는 아이러니한 시대、これが 바로 2025年の風景です。
3. 経済的崩壊:レモン市場とモデルの認知症
なぜここまで必死に戦わなければならないのでしょうか?
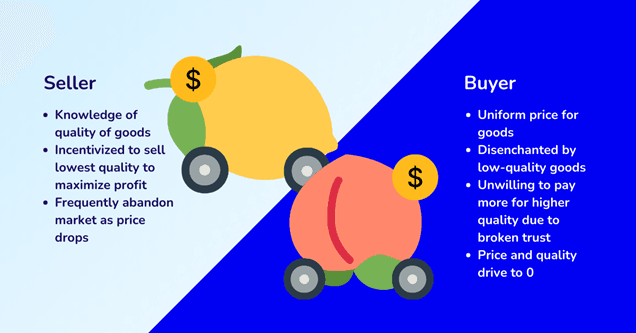
根本的な原因は、AIデータ市場が急速に**「レモン市場(Market for lemon)」**に変質しているからです。
3.1. ゴミがゴミを生む
経済学で「レモン」とは、見た目は立派でも中身は腐った不良品を指します。
今、インターネットはAIが書いた魂のない文章や絵で溢れかえっています。
最も大きな問題は、**「何が人間が作ったものか区別できない」**という点です。
結局、本当に人間が書いた質の高い情報(論文、深層エッセイ)は有料壁(Paywall)の後ろに隠れてしまい、無料ウェブにはAIが吐き出したスパム的なコンテンツだけが残ることになります。
3.2. モデル崩壊(Model Collapse):AIの近親交配
さらに恐ろしいのは**「モデル崩壊」**現象です。これを数式で表現すると以下のようになります。
$$S\_{t+1} = \\alpha D\_0 + (1-\\alpha) D\_t$$
(ここで $D\*0$ は純粋な人間データ、$D\*t$ はAIが生成したデータです。)
複雑に見えますが、核心はシンプルです。
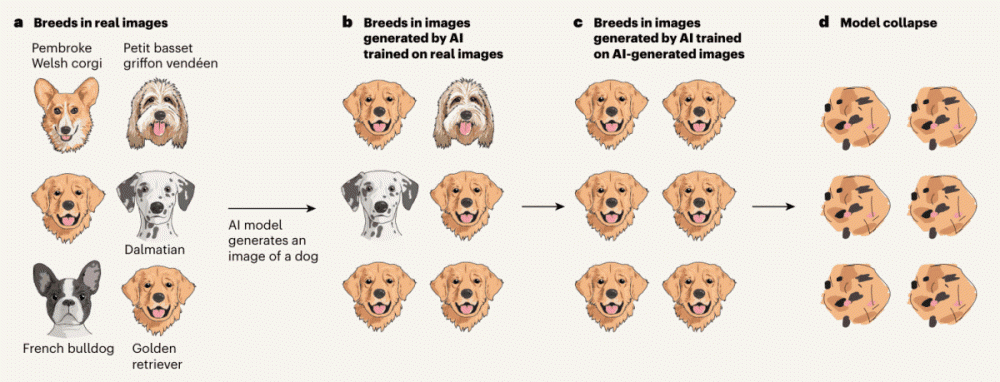
AIが他のAIが作ったデータを再び学習するとどうなるでしょうか?
まるで生物学的な近親交配のように、遺伝的多様性が失われます。
創造的でユニークな表現は絶滅し、ありきたりで平均的な答えしかしない**‘愚かなAI’**になってしまうのです。
研究によると、わずか5世代程度繰り返すだけで、AIは現実からかけ離れた戯言を言い始めます。これを「AI認知症」とも呼びます。
このため、2023年以前、すなわち生成AIが爆発する前に人間が作成した**「ヴィンテージデータ(Vintage Data)」**の価格が天井知らずに高騰しています。
まるで放射能に汚染されていない「核実験以前の鋼鉄」のように。
4. 断片化された世界:スプリンターネット(Splinternet)の到来
この戦争は、もはや企業を超え、国家間の規制戦争に広がり、インターネットを粉々にしています。
これを**「スプリンターネット(Splinternet、分割されたインターネット)」**と呼びます。
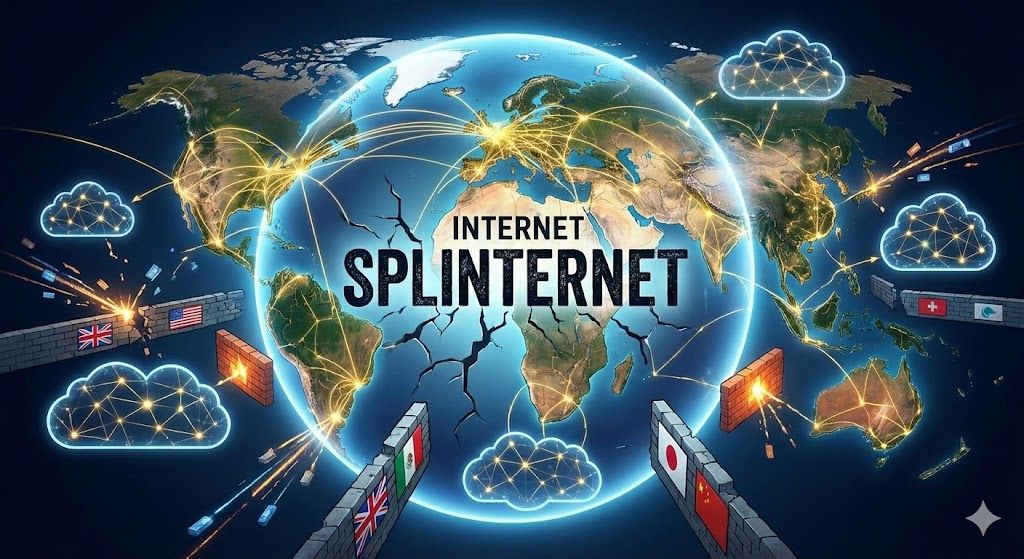
- アメリカ(法廷の戦場): ニューヨーク・タイムズがOpenAIを訴えた事件が象徴的です。**「私の記事を盗んで儲けるな」**という主張と**「公正利用(Fair Use)」**という主張が真っ向から対立しています。 * 欧州連合(規制の要塞): 世界で最も強力な**「AI法(AI Act)」を通じて透明性を要求**しています。「どのようなデータを使ったか全て明らかにしなさい」と圧力をかけ、規制を守れないAI企業は参入すら阻止します。 * 日本(学習の楽園): 真逆です。**「著作権を気にせず自由に学習しなさい」**と、世界で最も緩い法律を適用しています。全世界のAI企業を誘致するために、自ら「データ避難所」を名乗っています。
5. 未来展望:狩猟採集から農耕社会へ
私たちは今、情報革命の重大な転換点を通過しています。
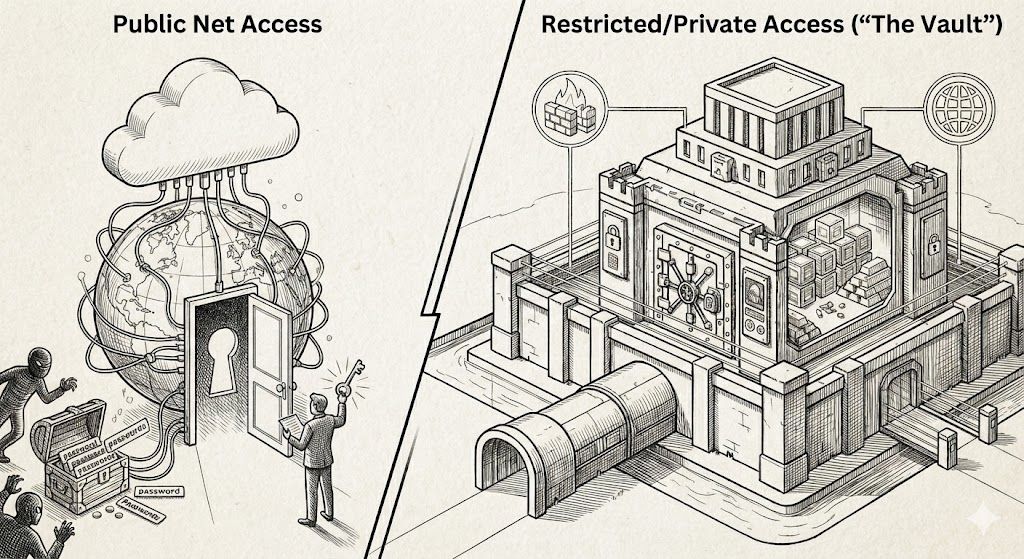
今後のウェブは、大きく二つの世界に分かれるでしょう。
- 公共ウェブ(Public Web): 誰でも見られるが、AIが作った低品質な情報や広告がゴミ捨て場のように溢れている場所。 2. 金庫ウェブ(The Vault): 人間が検証した高品質な情報がある場所。ここに入るには生体認証をするか、お金(HTTP 402)を払う必要があります。
新しい権力:データ労働組合と人間証明
この変化の中で、新しい形の組織が誕生するでしょう。
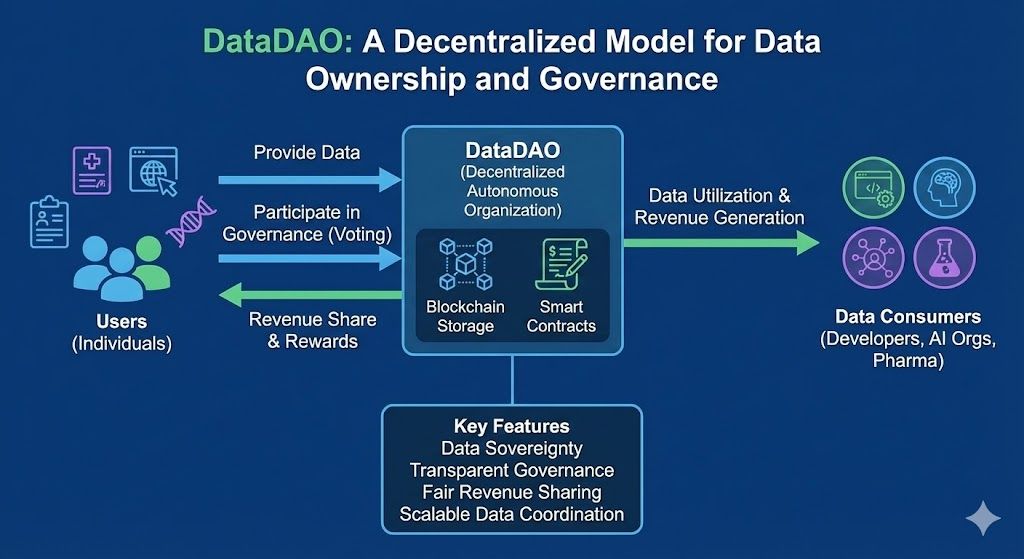
- データ労働組合(DataDAOs): 個人の力は微弱でも、団結すれば強力です。個人のデータを集めて巨大AI企業と交渉し、その収益を暗号資産で分配する**「デジタル労働組合」が登場するでしょう。 * 人間証明(Proof of Personhood): 未来最大のビジネスは、「私はボットではなく、血の通った人間です」を証明するサービスになるでしょう。CloudflareやWorldcoin**のような企業が、この「デジタル身分証明書」を発行する強力な権力を持つことになります。

Proof of Personhood
結論:ただ飯はもう終わり
Cloudflareが放った信号弾は、単なるセキュリティアップデートではありません。
それは**「データはもはや公共財ではなく、資産である。」**という巨大な宣言です。
私たちはこれまで、インターネットという森で、好きなように情報を摘み取る「狩猟採集民」でした。
しかし今、森には柵が張られました。
私たちは情報を耕し、管理し、正当な対価を支払わなければならない**「農耕社会」**へと強制的に移行させられています。
この変化が不快であったり、情報格差を広げる可能性もあります。
しかし、もしかしたらこれはAIの無限の複製の中で、**「人間の創造性」**という希少資源の価値を守るための必然的なプロセスなのかもしれません。
さて、最後に皆さんに問いたいと思います。
あなたが今日インターネットに残した思考の一片、その価値は一体いくらなのでしょうか?
参考文献
1 Cloudflare Blog: To build a better Internet in the age of AI, we need responsible AI bot principles (Easton & Zaheri, 2025)
\[Link\]2 Cloudflare Blog: Introducing pay per crawl: Enabling content owners to charge AI crawlers for access (Kresh & Vcelak, 2025)
\[Link\]3 GBHackers: Cloudflare Reveals AI Labyrinth to Counter Automated AI Attacks (Gurumoorthy, 2025)
\[Link\]4 DEV Community: Cloudflare’s JA4 Fingerprinting: Smarter Threat Detection Through TLS (Tech Analysis, 2025)
\[Link\]5 University of Chicago: Protecting Copyright - Nightshade & Glaze Project (Sandwich et al., 2025)
\[Link\]6 Nature: The AI Echo Chamber: Model Collapse & Synthetic Data Risks (Shumailov et al., 2024)
\[Link\]7 New York Times: OpenAI resists court order to share ChatGPT logs with NYT (Legal Report, 2025)
\[Link\]8 European Parliament: ‘Splinternets’: Addressing the renewed debate on internet fragmentation (Research Service, 2022)
\[Link\]参考文献
- Cloudflare Blog: To build a better Internet in the age of AI, we need responsible AI bot principles
- Cloudflare Blog: Introducing pay per crawl: Enabling content owners to charge AI crawlers for access
- GBHackers: Cloudflare Reveals AI Labyrinth to Counter Automated AI Attacks
- DEV Community: Cloudflare's JA4 Fingerprinting: Smarter Threat Detection Through TLS
- University of Chicago: Protecting Copyright - Nightshade & Glaze Project
- Nature: The AI Echo Chamber: Model Collapse & Synthetic Data Risks
- New York Times: OpenAI resists court order to share ChatGPT logs with NYT
- European Parliament: 'Splinternets': Addressing the renewed debate on internet fragmentation